Actualizado el 30 de octubre de 2026 · Guía para empresas en México
VPS escalable: qué verificar antes y después de ampliar recursos
Un VPS escalable permite evaluar cambios de recursos, pero no garantiza pasar de 2 GB a 64 GB sin interrupción, sin migración o conservando siempre la IP. La posibilidad depende del servicio, la configuración y la aplicación. Antes de contratar el cambio, separa lo solicitado, lo realmente aplicado, lo reconocido por el sistema operativo y el resultado de la operación que necesitas mejorar.
Esta guía conserva la idea de crecer por etapas, con respaldo y una ventana acordada. No ofrece una configuración universal ni ejecuta cambios de infraestructura. La portada es una ilustración conceptual de monitoreo, no una medición de tu VPS ni una mejora demostrada.
Cuatro comprobaciones, no una sola cifra en el panel
- Cambio solicitado: qué recursos, tamaño o familia se pidió, bajo qué condiciones y con qué autorización. Una solicitud aceptada no acredita la asignación.
- Cambio aplicado por la plataforma: evidencia de la operación y de los recursos que realmente ejecuta la máquina, no solo del nombre del plan mostrado.
- Recursos reconocidos por el sistema: memoria, procesadores y almacenamiento utilizables según la configuración del sistema operativo. Un disco mayor en el proveedor no implica automáticamente más espacio disponible en su sistema de archivos.
- Operación aceptada: la tarea acordada termina correctamente bajo condiciones comparables y no deja sin revisar funciones importantes. Tener más recursos no es ese resultado.
La documentación de cambio de tamaño en Azure advierte que una operación fallida puede dejar mostrado el tamaño solicitado aunque la máquina siga ejecutando el anterior. Es un ejemplo específico de producto, no una afirmación sobre el panel de CBW. Explica por qué conviene preguntar qué evidencia acredita cada estado.
Qué confirmar antes de prometer «sin migrar»
Solicita al proveedor el tamaño compatible, su disponibilidad para la máquina actual y las condiciones del cambio. Pregunta si requiere reinicio, parada, reasignación de host o traslado a otra instancia, y qué ocurre con las direcciones, discos y dependencias. No deduzcas la respuesta únicamente de la palabra «escalable».
Azure documenta reinicio al cambiar el tamaño de una máquina en ejecución y casos que requieren desasignarla; esa desasignación libera direcciones dinámicas. Por su parte, EC2 para instancias respaldadas por EBS exige detener la instancia para cambiar su tipo y distingue el comportamiento de una IPv4 pública no elástica. Son dos ejemplos de condiciones reales, no procedimientos que debas ejecutar ni una descripción del alojamiento que tienes contratado.
El aumento en caliente —hot-add— debe confirmarse para el recurso, plataforma, sistema y aplicación concretos. No se presume por tener un VPS, y un cambio admitido sin reiniciar un componente tampoco acredita continuidad de todo el servicio. «Reinicio corto» no es un plazo que pueda prometerse sin comprobar el arranque y las dependencias.
Define una necesidad antes de elegir más RAM o vCPU
Describe una operación que hoy no cumple el resultado esperado: qué hace, con qué datos y carga, cómo se observa el problema y cuál es el objetivo acordado. Después distingue una falta de capacidad de una espera por bloqueo, dependencia externa o configuración. El tamaño de la memoria no identifica la causa.
- Memoria: pregunta qué recurso falta y cómo se comprobará que el sistema y la aplicación pueden utilizar la ampliación. No ajustes búferes de una base de datos con una regla genérica por haber comprado más RAM.
- vCPU: más procesadores asignados no demuestran que una tarea se pueda paralelizar ni que su espera disminuya. Compara la misma operación; no conviertas un cambio de cantidad en prueba de causalidad.
- Almacenamiento: distingue espacio, rendimiento y disponibilidad. Aumentar capacidad no acredita mejores tiempos de disco, y un disco distinto tampoco resuelve automáticamente una dependencia de red.
Si el tamaño actual cumple y el problema está en otra parte, mantenerlo puede ser la decisión correcta. No necesitas alcanzar 64 GB para que el proyecto sea profesional ni cambiar varios recursos a la vez sin poder explicar qué se pretende comprobar.
Ampliar un disco y ampliar el espacio utilizable son tareas distintas
La guía de expansión de discos Linux en Azure distingue aumentar el disco administrado y extender la partición y el sistema de archivos. También limita los casos de expansión sin desasignar la máquina. Ese procedimiento no se traslada automáticamente a Windows, LVM u otro proveedor.
Antes de intervenir, el operador debe identificar el volumen, su uso, el sistema de archivos y qué operación admite. Confirma quién realiza y verifica cada etapa. No basta ver el nuevo tamaño contratado si la aplicación sigue escribiendo en otro volumen o no dispone del espacio esperado.
No ofrecemos comandos de particionado ni una receta para reducir discos. El plan de retorno debe describir una alternativa realmente admitida; no asumir que todo crecimiento puede deshacerse invirtiendo el número del panel. Conserva también cómo se tratarán los datos escritos después del cambio.
Prepara una ventana y un retorno que no oculten pendientes
Acuerda responsable, alcance y criterio para detener el cambio. Identifica tareas, integraciones y personas afectadas; no pauses procesos de negocio indiscriminadamente. Si se necesita suspender una tarea, debe formar parte del procedimiento autorizado y de su posterior reanudación.
- Estado previo: configuración y versiones pertinentes, operación de referencia y datos que deben conservarse.
- Respaldo: contenido, fecha, posibilidad de recuperación y responsable. Una copia no demuestra por sí sola el tiempo de recuperación ni que contenga escrituras posteriores.
- Ventana: impacto esperado, cómo se comunicará una demora y quién decide continuar o detenerse. No inventar un número universal de minutos.
- Retorno: qué alternativa está admitida, sus dependencias y cómo preservar o conciliar datos nuevos. Volver a una configuración anterior no garantiza recuperar todo sin impacto.
- Costos y licencias: cambios de cuota, respaldo, administración y derechos aplicables al producto, versión y programa contratado. No calcular licencias por una regla genérica de usuarios o vCPU.
Los objetivos de recuperación que acuerde el negocio son objetivos, no resultados probados ni un SLA automático. Si falta evidencia del respaldo o de la alternativa de retorno, la ausencia debe permanecer visible antes de autorizar el cambio.
Después: comprobar el recurso y comparar la operación
Pide evidencia del cambio aplicado y del recurso reconocido por el sistema. Después repite la tarea acordada con condiciones comparables: versión, datos, carga, ventana, origen de observación e instrumento. Conserva errores y observaciones faltantes, no solo el mejor tiempo.
Una respuesta de red, el primer byte y una operación completa no son la misma métrica. La definición de TTFB en web.dev incluye fases de conexión y respuesta; no es solo tiempo de CPU ni la tarea completa. Debes conservar la definición del instrumento utilizado. Por eso reutilizamos un esquema y un recurso de nuestra guía de comparación de tiempos y disponibilidad. Su propósito aquí es practicar cómo leer una comparación antes/después, no dimensionar RAM ni demostrar que un VPS mayor causó una mejora.
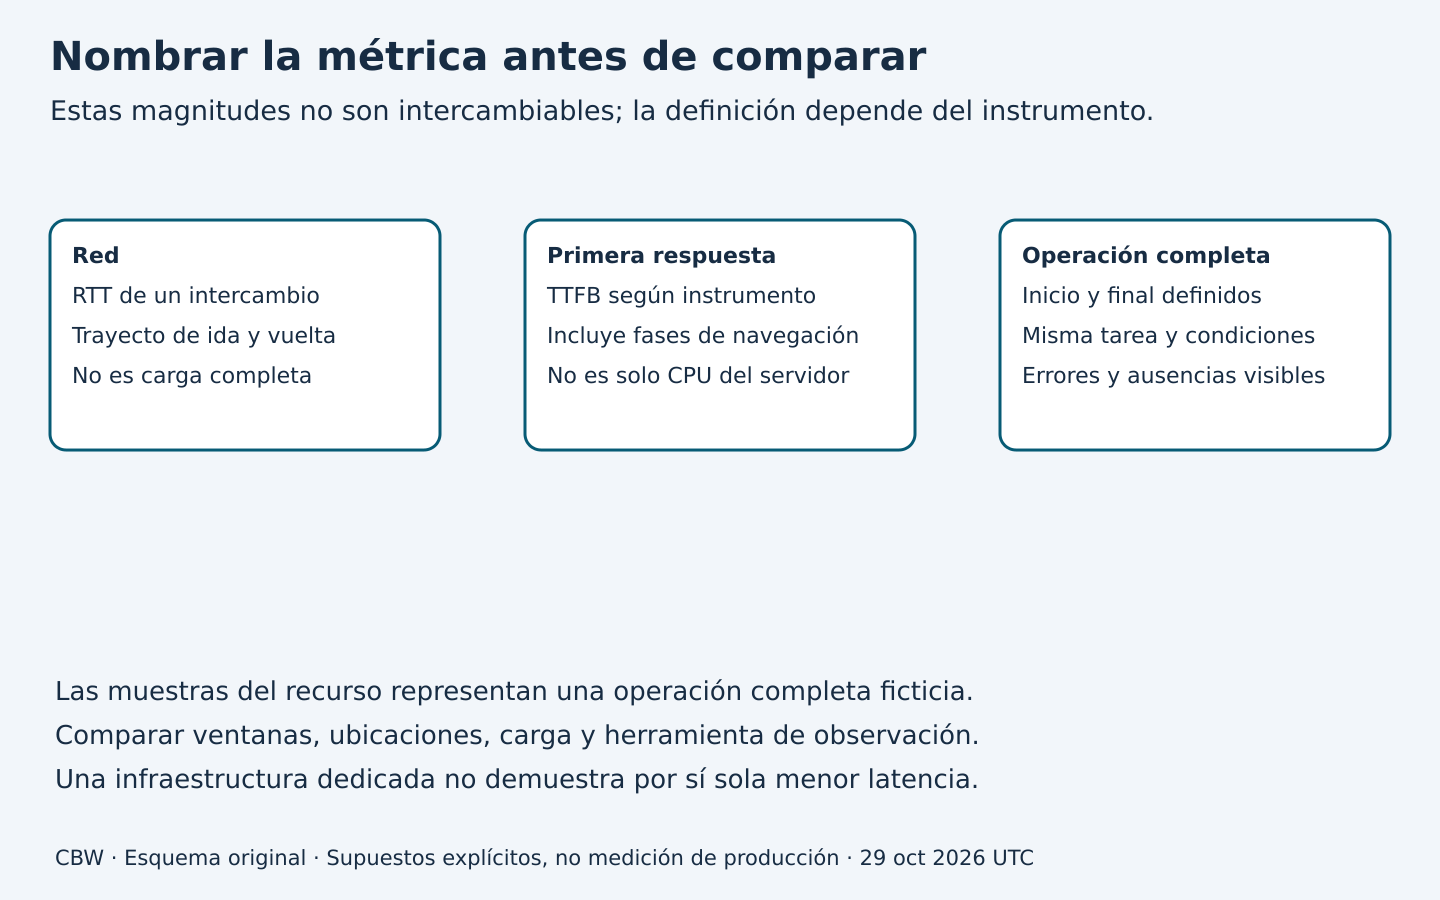
Abrir «Una mediana menor puede ocultar una cola mayor». Es un recurso separado de Servidores Web Nube Cloud, con cálculos locales y ejemplos ficticios; no mide servidores ni recibe registros reales. «Volver al artículo» conduce a la guía de origen; utiliza Atrás del navegador para regresar aquí.
Manual con dos muestras, sin convertirlo en un benchmark
Pulsa «Restablecer ejemplo» antes de cada variación. En «Muestra A: hasta 100 entradas, enteros 0–100000 ms, F o ?» introduce 100,110,120,130,900,F,?. En «Muestra B: misma métrica y formato» introduce 150,160,170,180,190. Pulsa «Evaluar ejemplo ficticio».
Para este ejercicio puedes llamar A «antes» y B «después», siempre como supuesto de la misma operación, no datos de una ampliación realizada. A contiene siete intentos listados: cinco duraciones de éxitos, un fallo y un faltante. B tiene cinco duraciones. A produce p50 de 120 ms y p95 de 900 ms; B, 170 y 190 ms. La mediana de B es mayor y su p95 menor. Esa combinación no permite declarar que todo mejoró ni que el hardware sea la causa.
- Una duración cambia: restablece y conserva ambas muestras iniciales; sustituye solo 900 por 140 en A. Evalúa: p50 sigue en 120 y p95 pasa a 140; el fallo y el faltante permanecen.
- Sin duraciones: restablece y cambia solo A a
F,?. Evalúa: hay un fallo y un faltante, pero ningún percentil de duración. No son dos respuestas de cero milisegundos. - Muestra par: restablece y cambia solo A a
100,200. Evalúa: con esta convención p50 es 100 y p95 es 200; no se promedian los dos valores centrales.
La herramienta admite hasta 100 entradas y 1000 caracteres por muestra: enteros de 0 a 100000 milisegundos, F o ?, separados por comas. Un dato desconocido no se sustituye por cero. Cero es un valor ilustrativo, no prueba de respuesta física instantánea. «Descargar ejemplo TXT» y «Descargar ejemplo JSON» guardan el escenario local, no evidencia de producción.
Alternativa sin JavaScript: separa éxitos, fallos y faltantes; ordena solo las duraciones de los éxitos. La posición se calcula como techo de p × n, contando desde 1: p vale 0.50 o 0.95 y n es el número de duraciones. Con cinco valores se toman las posiciones 3 y 5. Sin duraciones no hay percentil. En muestras pequeñas p95 puede ser el máximo: no demuestra comportamiento de producción, significancia ni disponibilidad anual. No promedies percentiles de ventanas diferentes.
Cuándo puede darse por aceptado el cambio
El expediente debe separar lo que se pidió, lo que se aplicó, lo que reconoce el sistema y lo que se comprobó en la aplicación. Si el proveedor asignó memoria pero la tarea sigue fallando, la ampliación y la aceptación funcional tienen resultados distintos. Si mejora una muestra pero faltan errores o condiciones comparables, la conclusión sigue limitada.
Conserva versión, fecha, resultados y pendientes. Acuerda el seguimiento según el riesgo y el patrón de uso, no una revisión quincenal universal. No generes cargas, pagos, correos ni operaciones reales solo para completar una lista de comprobación.
Tu equipo puede coordinar estas decisiones si dispone de evidencia y capacidad. Un socio aporta valor al delimitar el cambio, documentar condiciones y revisar resultados; no por vender el siguiente tamaño. Puedes consultar a Cobalt Blue Web sobre un cambio de capacidad con un resumen sin secretos. Confirma alcance, costos y responsabilidades; esta guía no acredita recursos, soporte o tiempos incluidos.
IA para revisar supuestos, no para elegir el tamaño por ti
Una IA puede ordenar una ficha ficticia de cambio o señalar que faltan condiciones de comparación. Puede confundir tamaño solicitado con aplicado, calcular percentiles con otra convención o inventar compatibilidad y licencias. Verifica con documentación y responsables; no introduzcas credenciales, configuraciones sensibles ni datos privados. No hace falta contratar IA para completar la ficha y su salida no autoriza una ampliación.
Fuentes pertinentes revisadas el 30 de octubre de 2026 (UTC). Recurso y esquema reutilizados conservan su procedencia original. No se han ejecutado ampliaciones ni mediciones de producción mediante esta guía.