Contratar un servidor virtual para ERP y CRM consiste en alojar un conjunto de procesos y dependencias, no solo dos aplicaciones. Ventas puede crear una oportunidad en el CRM mientras el ERP administra inventario, pedidos o finanzas. Si ambos intercambian información, debes saber qué sistema conserva cada dato y qué ocurre cuando falla la conexión entre ellos.
Esta guía te ayuda a dibujar ese mapa, decidir qué conviene compartir o separar y pedir un alcance de operación y recuperación. No promete facturación sin interrupciones, ahorro porcentual ni un SLA universal por trasladar el software a la nube.
1. Identifica qué debe funcionar además del servidor
Diagrama original de apoyo; sus criterios se desarrollan en el texto. Ampliar diagrama.
Empieza por una operación completa, por ejemplo: una oportunidad aceptada se convierte en pedido y el equipo comercial recibe su estado. No presupongas que ERP y CRM comparten base de datos, fabricante o versión; pueden comunicarse mediante un conector, una API o un intercambio programado.
La tabla siguiente es un inventario de diseño. En móvil se desplaza horizontalmente y puede recibir foco de teclado. Completa únicamente lo que existe en tu instalación.
Componente, dato y responsable que debes identificar
Capa
Qué documentar
Pregunta que evita un hueco
Usuarios y acceso
Oficinas, acceso remoto, identidad, perfiles y mecanismos de revocación.
¿Quién puede trabajar si falla la conexión de una oficina?
Aplicaciones ERP/CRM
Fabricante, edición, versión, módulos y personalizaciones soportadas.
¿El fabricante admite el sistema operativo y el despliegue propuesto?
Datos y archivos
Bases de datos, documentos adjuntos, rutas, configuración y tamaño actual.
¿Qué falta si recuperamos solo la base de datos?
Integración
Conector, sentido de intercambio, frecuencia, identificadores y registro de errores.
¿Cómo se detecta y corrige un pedido que no llegó o llegó dos veces?
Servicios externos
Correo, identidad, pagos u otros servicios realmente utilizados; límites y responsables.
¿Qué tarea se detiene aunque el VPS siga encendido?
Operación y recuperación
Monitoreo, copias, alertas, restauración, soporte y coordinación.
¿Quién reúne a los proveedores y valida que el proceso quedó consistente?
La infraestructura puede estar disponible mientras la aplicación o una dependencia falla. La documentación de fiabilidad de máquinas virtuales de Microsoft diferencia la VM del diseño de la aplicación y sus componentes. Pide medir el proceso que necesita tu empresa, no solo conectividad del servidor.
2. Decide qué compartir y qué separar
Una sola VM puede simplificar un despliegue compatible y su administración inicial, pero concentra recursos y mantenimiento. Una carga de reportes, actualización o incidente puede afectar a ambos sistemas. No la descartes por principio ni la elijas solo porque requiere menos máquinas: revisa compatibilidad y exposición.
VMs separadas pueden permitir ventanas, permisos o capacidad distintos. A cambio, agregan red, configuración, costos y coordinación. Si ambas dependen de la misma base de datos o identidad, esa dependencia puede seguir siendo común. Separar procesos no crea automáticamente alta disponibilidad.
Una combinación con SaaS también puede tener sentido: por ejemplo, conservar un CRM contratado como servicio y alojar un ERP compatible en infraestructura propia o administrada. Confirma interfaces, exportación, licencias y soporte. No migres una aplicación que ya satisface la operación únicamente para que todo tenga la misma etiqueta “cloud”.
No dimensionar solo por usuarios registrados
Documenta concurrencia real, tareas pesadas, tamaño y crecimiento de datos, integraciones y horarios. Un usuario generando un reporte complejo no representa la misma carga que otro consultando una ficha. Solicita al integrador una configuración compatible y un piloto acotado, no una regla universal de RAM por usuario.
Incluye licencias de sistema operativo, base de datos y aplicación según el modelo que corresponda. Verifica restricciones de virtualización y acceso con el fabricante o distribuidor autorizado. Este artículo no certifica compatibilidad ni derechos de uso de una edición concreta.
3. Comprueba qué ocurre cuando una operación queda a medias
En una integración, un tiempo de espera no prueba que el destino no haya procesado la solicitud. El patrón de reintentos de Microsoft advierte del riesgo de repetir efectos cuando una operación no es idempotente, es decir, cuando repetirla puede cambiar otra vez el resultado.
Con el responsable del conector, diseña un ensayo en un entorno aislado con datos ficticios. No provoques fallos ni duplicados en producción y no generes cobros o documentos reales.
Establece una referencia única. Crea una oportunidad ficticia con un identificador que puedas seguir entre sistemas. Anota el resultado esperado y dónde debe aparecer.
Completa el recorrido normal. Comprueba el pedido en ERP y el estado esperado en CRM. Verifica identificadores, cantidades y adjuntos pertinentes, no solo que ambos permitan iniciar sesión.
Ensaya una falla controlada del intercambio. El integrador define un mecanismo seguro de simulación. Observa si se muestra pendiente, error o completado y quién recibe la alerta.
Comprueba la recuperación del intercambio. Determina si corresponde consultar el estado, reintentar o conciliar manualmente. No pulses repetidamente “enviar” sin conocer el comportamiento del conector.
Reconcilia el resultado. Debe haber la cantidad de operaciones esperada, sin omisiones ni duplicados. Guarda evidencia y responsable de corregir una diferencia.
Ejemplo de un resultado que no debe aceptarse
Escenario hipotético, no prueba de un cliente. El CRM envía el pedido de prueba P-001; el ERP lo crea, pero el CRM no recibe la confirmación. Un reintento sin protección crea otro pedido. Ambos servidores están en línea, pero el proceso no es correcto.
La solución no es necesariamente más CPU ni otra VM. El integrador debe definir cómo identificar una operación ya procesada y cómo conciliar el estado. La prueba se repite hasta demostrar el comportamiento acordado, sin inventar una garantía de que cualquier conector lo ofrece de fábrica.
4. Recupera el conjunto de datos que necesita el proceso
Inventaría bases de datos, adjuntos, configuración, personalizaciones y credenciales recuperables por un mecanismo seguro. No guardes secretos en una ficha compartida ni asumas que una copia del disco sustituye el procedimiento específico de la aplicación.
Si ERP y CRM se recuperan a momentos distintos, sus estados pueden no coincidir. Define con los responsables cómo detener o aislar el intercambio durante la restauración, qué sistema es referencia para cada dato y cómo reconciliar operaciones posteriores al punto recuperado. No reinicies el conector a ciegas sobre dos copias desalineadas.
La guía de recuperación de AWS distingue estrategias y subraya la prueba. Para este caso, una prueba útil termina cuando el proceso ERP–CRM funciona con datos consistentes, no cuando el servidor vuelve a responder.
Una matriz mínima para recuperar sin adivinar
Dato maestro: para clientes, productos, pedidos y estados, indica qué sistema manda y cómo identificar registros.
Punto recuperado: anota la fecha y hora de cada copia y lo que falta desde ese momento.
Intercambio pendiente: identifica operaciones confirmadas, pendientes o de resultado incierto.
Validación: asigna a negocio la comprobación de cantidades y estados, y a TI el funcionamiento y permisos.
Reanudación: autoriza el intercambio solo después de resolver diferencias y registrar la decisión.
5. Delimita soporte, contrato y costos
El modelo de responsabilidad compartida de AWS ayuda a distinguir infraestructura de sistema y aplicación. Tu contrato concreto debe indicar quién administra cada capa. No supongas que contratar VPS administrado incluye corregir personalizaciones del ERP, licencias o integraciones de terceros.
Solicita un responsable de coordinación, con canales y horarios. Diferencia primera respuesta, diagnóstico, recuperación de infraestructura y corrección funcional. Si se promete disponibilidad, pide documento, servicio cubierto, período y exclusiones; un 99.9% anunciado no garantiza que la facturación nunca se detenga.
Compara el costo del mismo alcance: infraestructura, licencias, administración, integración, respaldo, pruebas, migración y salida. No existe un ahorro universal del 60% por mover ERP y CRM a un servidor virtual. Puede cambiar quién paga qué y cuándo; exige una comparación documentada para tu operación.
Ficha de arquitectura para solicitar propuesta
Copia este formato en tu documento interno. No captura información ni ejecuta conexiones.
ERP / CRM y versiones: ____ Fabricantes e integradores: ____ Proceso que intercambian: ____ Sistema maestro por tipo de dato: ____ Conector, frecuencia e identificador: ____ Datos, adjuntos y configuración a proteger: ____ Dependencias externas: ____ Carga y ventanas de trabajo: ____ Objetivos de recuperación acordados: ____ Responsable por capa y coordinador: ____ Prueba de fallo parcial y conciliación: ____ Licencias, alcance excluido y salida: ____
IA para documentar dependencias, no para decidir sobre datos
Una herramienta de IA puede ayudarte a convertir descripciones anonimizadas en un mapa de preguntas o detectar componentes sin responsable. No puede producir un inventario fiable sin datos verificados, y puede sugerir reintentos o restauraciones que dupliquen operaciones. No compartas bases de clientes, nómina, claves ni archivos completos. Validar compatibilidad, consistencia y cambios corresponde a responsables técnicos y de negocio.
¿ERP y CRM deben alojarse siempre juntos?
No. Depende de compatibilidad, carga, integración, mantenimiento y operación. Compartir puede simplificar algunos aspectos; separar puede aislar otros, pero introduce dependencias que deben administrarse.
¿Una copia diaria basta para cualquier empresa?
No necesariamente. La pérdida de datos y el tiempo de recuperación tolerables dependen del proceso. Define objetivos, elige un procedimiento compatible y pruébalo con el conjunto de componentes.
¿Cambiar de servidor arreglará un conector que duplica pedidos?
No por sí solo. Hay que revisar la lógica de identificación, confirmación y recuperación del intercambio. La infraestructura y la integración requieren evidencias distintas.
Solicita un alcance completo para tu operación
Si necesitas revisar la arquitectura, comparte con Cobalt la ficha de ERP y CRM, sin datos sensibles. Pide identificar lo que cubre infraestructura y lo que corresponde al integrador. También puedes usarla con otros proveedores: el objetivo es que ninguna dependencia crítica quede sin dueño.
Comprar un VPS escalable significa contratar una ruta de crecimiento que puedas comprobar, no recibir una promesa universal de cambios en segundos y sin cortes. Ampliar memoria, cambiar CPU, extender un disco o añadir otra máquina son operaciones diferentes. Cada una puede tener requisitos, costos y efectos distintos.
Esta guía te permite convertir la palabra “escalable” de una oferta en un plan de cambio: qué aumenta, cuándo estará disponible, cómo se valida y qué hacer si no funciona. También explica por qué reducir recursos no siempre es el camino inverso de ampliarlos.
1. Separa tres formas de crecer
Diagrama original de apoyo; sus criterios se desarrollan en el texto. Ampliar diagrama.
Cambiar el tamaño de una máquina
Asignas otro perfil de CPU o memoria a la VM. Puede requerir reinicio, detenerla o moverla a otro host. Antes del cambio confirma compatibilidad, capacidad disponible y ventana. La documentación de redimensionamiento de Azure muestra un caso concreto en el que cambiar el tamaño de una VM en ejecución provoca reinicio; no lo extrapoles como procedimiento de todos los proveedores, pero tampoco aceptes “sin cortes” sin evidencia.
Ampliar almacenamiento
Aumentar el volumen no siempre deja el espacio listo dentro del sistema operativo. Puede hacer falta extender partición y sistema de archivos mediante el procedimiento compatible. Verifica también si crece la capacidad, el rendimiento o ambos.
Añadir máquinas
Repartes trabajo entre instancias. La aplicación debe gestionar correctamente sesiones, archivos, datos y trabajos pendientes; duplicar servidores no duplica automáticamente la capacidad útil.
El procedimiento de Elastic Volumes de AWS ilustra otra diferencia: ciertas ampliaciones compatibles pueden hacerse sin reiniciar, pero tienen estados, límites y restricciones. En ese servicio no se reduce el tamaño de un volumen por la misma operación. Revisa las reglas de tu plataforma, no una afirmación genérica sobre virtualización.
Automático no significa instantáneo ni ilimitado
El escalado automático requiere una política, señales y capacidad disponible. La documentación de EC2 Auto Scaling distingue capacidad deseada de capacidad lista para usar y contempla períodos de calentamiento. Es un ejemplo de por qué una orden de crecimiento no equivale al resultado ya disponible.
Antes de contratar automatización, pregunta quién define mínimos y máximos, qué métrica dispara el cambio, qué ocurre si falla y cómo se evita añadir y retirar recursos repetidamente. Una alarma de CPU no demuestra por sí sola que el cuello de botella se resuelva con más máquinas. La reducción también debe respetar sesiones, trabajos y datos pendientes.
2. Pide una respuesta específica para cada recurso
La tabla se puede desplazar horizontalmente en móvil; su región también puede recibir foco de teclado. Completa una fila por cambio que realmente necesitarás.
Convertir “escalable” en condiciones verificables
Cambio
Qué debe aclarar el proveedor
Qué validar después
Más CPU o memoria
Perfiles compatibles, reinicio, disponibilidad, licencia y costo mínimo de la nueva configuración.
Recursos observados por el sistema y mejora de la tarea que motivó el cambio.
Más espacio
Volumen, partición y sistema de archivos, máximos, persistencia y posibilidad real de reducir luego.
Espacio utilizable por la aplicación, permisos y conservación de datos.
Más rendimiento de disco o red
Límites sostenidos, dependencias del tamaño de VM y condiciones de medición.
Latencia y transferencia bajo la carga acordada, sin más errores.
Más instancias
Balanceo, estado compartido, base de datos, preparación de nuevas instancias y retirada segura.
Sesiones, integridad de datos y continuidad de trabajos durante alta y baja de nodos.
Reducir recursos
Operación soportada, mínimos, datos que deben moverse y ventanas de mantenimiento.
Que siga cabiendo la carga y que no se pierdan datos ni tareas.
No basta con que un botón exista en el panel. Solicita el límite máximo del plan, el mecanismo para reservar capacidad si existe, el plazo operativo y quién atiende una falla. No conviertas la disponibilidad habitual en una garantía que no aparece en la oferta.
3. Mide hasta que la aplicación esté lista
Ejemplo hipotético, no tiempos de un proveedor. Imagina un cambio con 3 minutos para ejecutar la solicitud, 4 para reiniciar e iniciar servicios y 8 para validar acceso, datos y una operación crítica. El tiempo hasta la aceptación sería 3 + 4 + 8 = 15 minutos, aunque el panel hubiera completado su parte en 3.
Si una ventana acordada fuera de 20 minutos, esos supuestos dejarían 5 minutos antes de agotarla. Eso no demuestra que alcance para regresar: si la reversión ensayada necesitara 10 minutos, el límite teórico para iniciar el retorno sería el minuto 10 (20 − 10), antes si necesitas margen de seguridad. No podrías esperar al minuto 15 para terminar toda la validación: tendrías que ajustar el ensayo, detener el intento antes o acordar otra ventana. Decide el momento límite de retorno antes del cambio, no cuando el negocio ya está detenido.
La cuenta sirve para preparar preguntas. El ensayo real debe medir desde el momento relevante para los usuarios hasta que el proceso vuelve a ser utilizable. Registra aparte ejecución técnica, recuperación del servicio y validación funcional; no ocultes esta última detrás de “servidor encendido”.
4. Un plan de cambio que permita detenerse a tiempo
Documenta la causa. Guarda evidencia de la limitación y define qué tarea mejorará. Si el problema es una consulta, una integración o un recurso del navegador, puede corresponder optimizar antes de ampliar.
Comprueba compatibilidad y costo. Revisa sistema operativo, aplicaciones, licencias, arquitectura, discos y red del perfil objetivo. Confirma desde cuándo se factura y si el regreso reduce el cargo de inmediato o no.
Prepara copia y retorno. Conserva configuración y datos recuperables, verifica el procedimiento y asigna responsables. Una captura de pantalla del plan anterior no es un respaldo.
Ensaya en un entorno autorizado. Usa una copia representativa protegida, sin efectos externos reales. Registra duración, datos y resultados. No ejecutes una prueba de carga sobre producción sin límites y ventana acordados.
Define el punto de decisión. Antes de producción fija qué falla obliga a parar, quién decide y cuál es el último momento seguro para iniciar el retorno.
Ejecuta y observa. Comprueba configuración real, servicios, datos, permisos y operación crítica. Conserva el registro aunque el resultado no sea favorable.
Cierra o regresa. Si no satisface el objetivo, aplica el procedimiento de retorno acordado, teniendo en cuenta las escrituras realizadas después del cambio. No restaures una copia antigua sobre datos nuevos sin resolver esa diferencia.
Dos escenarios con planes diferentes
Campaña comercial prevista: ensaya y prepara capacidad antes del pico. Define qué tareas probarás, qué integra la tienda y qué sigue siendo un límite externo. No confíes en que la primera ráfaga de tráfico servirá también para validar la automatización.
Crecimiento sostenido de datos: vigila espacio útil y ritmo de crecimiento, pero no llenes el volumen para demostrar el problema. Solicita la ampliación con margen y verifica que el sistema operativo y la aplicación puedan usarla. La eliminación de archivos no equivale necesariamente a reducir la capacidad contratada.
En plataformas educativas o ERP, los usuarios registrados tampoco equivalen a usuarios ejecutando tareas simultáneas. Define el patrón de trabajo; no prometas que pasar de una cifra de usuarios a otra se resuelve con una proporción fija de CPU.
Costos y responsabilidades: lo que no cubre la palabra flexible
Pregunta por recursos mínimos, duración de cobro, almacenamiento retenido, licencias y trabajo técnico. Un plan mensual no se convierte automáticamente en pago por segundo porque permita crecer. Al comparar, usa el mismo período y la misma cobertura; no presupongas ahorro universal frente a un servidor físico o al servicio actual.
Un socio administrado puede ser útil si prepara el cambio, observa el proceso y coordina el retorno con el responsable de la aplicación. Solicita esas tareas explícitamente. El proveedor de infraestructura no necesariamente conoce las licencias, trabajos programados o efectos de negocio de tu software.
Ficha copiable para una ampliación
Motivo y evidencia: ____ Configuración actual y objetivo: ____ Operación exacta y límites: ____ Reinicio o interrupción prevista: ____ Costo y fecha de inicio del cargo: ____ Copia recuperable y prueba: ____ Tarea funcional y resultado aceptable: ____ Tiempo ensayado de cambio y retorno: ____ Último momento para decidir retorno: ____ Responsables y canal de comunicación: ____ Resultado observado y decisión final: ____
La ficha no envía datos ni ejecuta cambios. Puedes utilizarla con tu equipo o con cualquier proveedor, y conservarla junto al registro de configuración.
IA para organizar el plan, no para autorizar el cambio
Una herramienta de IA puede convertir una propuesta anonimizada en preguntas o ayudarte a detectar campos faltantes. Verifica cálculos, compatibilidad y procedimientos con documentación de tu plataforma. No le entregues accesos ni ejecutes instrucciones de redimensionamiento sin revisar: puede inventar opciones, omitir reinicios o proponer una reducción de disco que el servicio no admite.
¿Puedo volver al tamaño anterior si algo falla?
Depende del cambio, los límites del servicio y los datos escritos después. Comprueba compatibilidad, capacidad disponible y procedimiento de retorno antes de empezar. Reducir almacenamiento puede requerir migración a otro volumen.
¿Escalar automáticamente garantiza continuidad?
No. La automatización añade mecanismos, pero debe diseñarse y probarse con la aplicación y sus dependencias. Un recurso puede tardar en estar disponible o no resolver el cuello de botella.
Solicita una ruta de crecimiento, no solo un plan mayor
Si necesitas apoyo, comparte con Cobalt la ficha de ampliación, sin secretos ni respaldos de producción. Pide límites, ventana, validación y retorno por escrito. Si el diagnóstico no justifica más capacidad, optimizar o mantener el servicio actual también puede ser la decisión adecuada.
Comprar un VPS con disco SSD requiere comprobar dos cosas distintas: cómo responde el almacenamiento y qué disponibilidad compromete el servicio. SSD no significa “sin interrupciones”, y un porcentaje de uptime no describe la velocidad de una consulta. Compara ambas partes por separado antes de aceptar una oferta.
Esta guía te ayuda a pedir especificaciones útiles, detectar condiciones omitidas y preparar una prueba segura. No presenta precios ni benchmarks de proveedores, y no atribuye un SLA de 99.9% a Cobalt ni a cualquier plan sin un contrato aplicable.
1. El tipo de disco no es la especificación completa
Un SSD utiliza almacenamiento de estado sólido; un HDD emplea mecanismos físicos para acceder a sus superficies magnéticas. En una oferta de VPS, además del medio físico importan la asignación, el acceso al almacenamiento y los límites del servicio. No interpretes la palabra SSD como un multiplicador universal de velocidad.
La documentación de tipos de volumen de Amazon EBS distingue perfiles optimizados para operaciones pequeñas y frecuentes de otros orientados a transferencias grandes y secuenciales. Esa clasificación ilustra por qué hay que conocer el trabajo que realizará el volumen; no certifica el comportamiento de otro proveedor.
Diagrama original de apoyo; sus criterios se desarrollan en el texto. Ampliar diagrama.
Tres medidas que debes solicitar juntas
IOPS: operaciones de entrada/salida por segundo. Una cifra sin tamaño de operación, lectura/escritura y condiciones de prueba no permite comparar propuestas.
Transferencia: cantidad de datos por unidad de tiempo, con unidades explícitas. No es lo mismo disponer de muchas operaciones pequeñas que mover archivos grandes.
Latencia: cuánto tarda una operación en completarse. Pide conocer su comportamiento durante la carga que importa, no únicamente un promedio sin contexto.
La guía de características de E/S de AWS relaciona demanda, tamaño de operaciones y límites. No extrapoles una cifra obtenida con un patrón a otro: leer de forma secuencial y realizar muchas consultas pequeñas son escenarios diferentes.
2. Usa una ficha de comparación, no una tabla de promesas
En móvil desplaza la tabla horizontalmente; con teclado puedes enfocar la región para recorrerla. “No informado” es un resultado válido: pide aclaración antes de asumir lo favorable.
Campos que conviene completar para cada propuesta
Campo
Qué pedir por escrito
Señal de que falta evidencia
Capacidad y crecimiento
Espacio utilizable, ampliación, costo, ventana y límites del sistema de archivos.
Solo dice “escalable” sin procedimiento ni condiciones.
Perfil de rendimiento
IOPS, transferencia y condiciones; límites sostenidos frente a ráfagas cuando existan.
“Hasta” una cifra sin indicar qué ocurre después de la ráfaga.
Ubicación del almacenamiento
Si es local o un volumen conectado por otro mecanismo; persistencia y qué ocurre al sustituir el host.
Se habla de “cloud” como sustituto de esa explicación.
Prueba permitida
Entorno, duración, límites, conjunto de datos y responsable para interpretar el resultado.
Benchmark aislado del proveedor sin relación con tu aplicación.
Disponibilidad
Servicio cubierto, período, definición de indisponibilidad, exclusiones y procedimiento de reclamación.
Porcentaje en un banner sin documento aplicable.
Protección de datos
Copias, retención, aislamiento, restauración, costos y quién valida la copia recuperada.
“SSD confiable” presentado como reemplazo del respaldo.
Operación y salida
Responsables, horarios, licencias, exportación de datos y cancelación.
“Administrado” sin listado de tareas y exclusiones.
Ejemplo numérico: por qué las unidades importan
Ejemplo didáctico hipotético, no benchmark. Si un flujo realiza exactamente 2,000 operaciones por segundo de 8 KiB cada una, mueve 16,000 KiB/s = 15.625 MiB/s, usando 1 MiB = 1,024 KiB. Si cada operación fuera de 64 KiB y se mantuvieran esas mismas 2,000 operaciones, el cálculo sería 128,000 KiB/s = 125 MiB/s.
Son ocho veces más datos por segundo con el mismo número de operaciones. Pero no significa que un volumen pueda mantener ambos flujos: pueden intervenir límites, agrupación de operaciones, caché y latencia. Utiliza la cuenta para detectar propuestas incomparables, no para dimensionar producción sin prueba.
3. Uptime: lee el alcance antes del porcentaje
Un SLA es un compromiso de nivel de servicio con definiciones y condiciones. Comprueba si cubre conectividad de una instancia, infraestructura o algún servicio adicional. Tu aplicación puede fallar por causas que no se computan como indisponibilidad de ese componente.
Como ejemplo documental, el SLA de cómputo de AWS diferencia compromisos según despliegue, define indisponibilidad y establece créditos y exclusiones. No se transfiere ese contrato a un VPS de otro proveedor ni se deben copiar sus porcentajes a una cotización distinta.
Solicita el documento aplicable a tu oferta y pregunta: ¿qué se mide?, ¿desde dónde?, ¿en qué período?, ¿qué eventos no cuentan?, ¿qué evidencia hay que conservar?, ¿qué remedio corresponde? Un crédito de servicio no restaura datos ni equivale automáticamente a compensar todas las pérdidas del negocio. Confirma las condiciones concretas con el proveedor.
Qué representa 99.9% en una cuenta simple
Ejemplo aritmético, no garantía ni interpretación de un contrato. Para un período continuo hipotético de 30 días, hay 30 × 24 × 60 = 43,200 minutos. La fracción restante de 99.9% es 0.1%, es decir, 0.001: 43,200 × 0.001 = 43.2 minutos.
No son “cero interrupciones” ni minutos que puedan considerarse irrelevantes para cualquier empresa. Un mes de otra duración cambia el cálculo; la fórmula y las exclusiones del contrato determinan qué se contabiliza realmente. No conviertas un compromiso mensual en una promesa anual ni en un máximo garantizado de cada incidente.
Si una interrupción de unos minutos detiene un proceso crítico, la pregunta siguiente es cómo recuperarlo o mantenerlo operando. No basta con elegir el porcentaje más alto de una publicidad.
4. SSD no sustituye respaldo, recuperación ni administración
Distingue continuidad de servicio, conservación de datos y rapidez de acceso. Necesitas saber qué sucede ante borrado accidental, corrupción, fallo de acceso o pérdida del host, y quién actúa en cada caso. Una copia que no puedes restaurar no resuelve el problema por tener una etiqueta de respaldo.
La documentación de recuperación de AWS describe estrategias de distinta complejidad y la necesidad de probarlas. Pide una restauración aislada de aplicación, datos y configuración, con tiempos y validación funcional, en lugar de aceptar una captura de “copia completada”.
Para un VPS administrado, delimita sistema operativo, base de datos, aplicación, monitoreo y contacto durante incidentes. Atención disponible, primera respuesta y resolución son hitos distintos. No presupongas certificaciones, cobertura 24/7 o soporte funcional del software si no aparecen en la propuesta.
5. Prueba el trabajo real sin arriesgar producción
Define la operación que justifica SSD. Por ejemplo, guardar una transacción, abrir una consulta o procesar un archivo. Identifica qué resultado y espera acepta el negocio.
Prepara un entorno autorizado. Usa datos representativos sin secretos y evita conexiones que generen cargos o mensajes reales. No ejecutes herramientas de escritura de disco sobre datos de producción para comprobar una oferta.
Fija las condiciones comparables. Versiones, cantidad de datos, concurrencia, caché, lectura/escritura y duración deben registrarse. Si no puedes igualarlas, explica la limitación.
Observa el conjunto. Registra duración de la tarea, errores, latencia y carga de almacenamiento junto con CPU y memoria. Una consulta lenta no demuestra por sí sola que el disco esté saturado.
Contrasta los límites informados. Si el resultado empeora tras una ráfaga o al aumentar demanda, pide al operador identificar la restricción. No cambies varias variables sin dejar registro.
Valida recuperación y salida. Comprueba exportación, copia y restauración separada. Acepta únicamente lo demostrado bajo esas condiciones y documenta qué falta.
Una prueba de estrés necesita permiso, límites y ventana acordada. Este artículo no te pide saturar el servicio ni proporciona comandos destructivos. Si no tienes personal para diseñar y observar el ensayo, contrata ese alcance explícitamente.
Preguntas listas para copiar a tu solicitud
Este texto es una plantilla; no captura ni envía información desde la página.
Necesito evaluar un VPS para [aplicación y operación]. ¿Qué capacidad útil, IOPS, transferencia y límites sostenidos incluye? Indiquen las condiciones de medición y las ráfagas si existen. ¿Qué límites aplica la VM? ¿Qué sucede con los datos al sustituir el host? Envíen el SLA aplicable, sus exclusiones y el procedimiento de reclamación. Especifiquen respaldo, restauración, soporte, licencias, moneda, impuestos, renovación y salida. Propongo validar [tarea] con [datos y concurrencia], sin afectar producción, y acordar previamente el resultado aceptable.
Compara el costo completo del mismo alcance. Una tarifa menor puede excluir almacenamiento adicional, restauración o administración; una mayor no prueba por sí sola mejor calidad. Usa las respuestas y el piloto para decidir, incluyendo la opción de no cambiar si tu servicio actual cumple.
IA para revisar omisiones, no para certificar ofertas
Un asistente puede ayudarte a detectar campos vacíos entre dos propuestas anonimizadas o a comprobar una cuenta mostrando su fórmula. Verifica unidades y resultados por separado. No le atribuyas acceso a métricas del proveedor ni capacidad para certificar un SLA: puede inventar condiciones o confundir disponibilidad y rendimiento. Conserva contrato, documentación y prueba como evidencias principales.
¿SSD o NVMe significa que mi sitio será más rápido?
No automáticamente. La etiqueta del almacenamiento no informa de todos los límites ni de la causa de la espera. Comprueba la tarea y el perfil de acceso, además de la especificación comercial.
¿Un VPS SSD mejora por sí solo el SEO?
No. La experiencia depende de toda la página y Google no garantiza primeras posiciones por buenas métricas, mucho menos por un tipo de disco. Puedes consultar su explicación de experiencia de página.
¿Debo rechazar cualquier plan sin un porcentaje publicado?
Primero solicita condiciones escritas y evalúa si satisfacen el riesgo de tu operación. Un porcentaje visible sin alcance tampoco es suficiente. No compres basándote en una garantía que no puedes identificar.
Solicita una propuesta comprobable
Si necesitas comparar opciones con Cobalt, envía tu solicitud de requisitos sin credenciales ni datos de clientes. Pide confirmar el alcance y las pruebas por escrito. Esta ficha también sirve para evaluar otros proveedores o continuar con tu infraestructura actual.
Un VPS puede mejorar el rendimiento de tu sitio web si corrige una limitación real de la infraestructura. No arregla automáticamente una imagen demasiado pesada, una consulta ineficiente, JavaScript que bloquea la pantalla o una integración externa lenta. Antes de migrar o ampliar recursos, identifica qué parte del recorrido espera el visitante.
Esta guía te ayuda a obtener una línea base, separar causas y decidir entre optimizar el sitio, ajustar la configuración o probar otro servidor. El resultado útil no es “tener más RAM”: es completar la misma tarea con menos espera y sin introducir errores.
1. Define qué significa “lento” para tu sitio
Elige páginas y tareas concretas: abrir una ficha de producto, buscar, añadir al carrito o consultar un curso. Incluye al menos una página pública que pueda servirse desde caché y una operación dinámica relevante. No uses cobros reales ni tareas que alteren pedidos para una prueba informal.
Registra URL, dispositivo, ubicación, conexión, hora, sesión iniciada o anónima y estado de caché. Compara condiciones equivalentes. Un escritorio conectado por cable no representa necesariamente a quien compra desde un teléfono; un administrador conectado puede recibir una versión de la página distinta de la del público.
Distingue respuesta, contenido visible y uso
TTFB: espera hasta que llega el primer byte. Incluye componentes de conexión y respuesta; no es una medición pura de CPU del servidor. La guía de TTFB de web.dev describe qué fases abarca.
LCP: momento en que se presenta el elemento de contenido más grande dentro de la vista. Si llega pronto el HTML pero tarda la imagen principal, comprar más CPU puede no resolver esa espera.
Interacción y resultado: verifica que botones, búsqueda y formularios respondan y completen su función. Una página que aparece rápido pero bloquea el carrito no está resuelta.
Errores: registra fallos y respuestas inesperadas junto con los tiempos. No declares una mejora porque el servidor devuelve una página de error más rápido.
Las mediciones de laboratorio ayudan a reproducir un escenario; las de campo describen experiencias reales agregadas. Google explica por qué pueden diferir. No mezcles sus resultados como si fueran una sola prueba. Si PageSpeed Insights no tiene datos de campo de esa URL, no significa que sea rápida ni que no tenga visitas; conserva el resultado disponible y su alcance.
Diagrama original de apoyo; sus criterios se desarrollan en el texto. Ampliar diagrama.
2. Relaciona el síntoma con una evidencia, no con una compra
En móvil puedes desplazar horizontalmente esta tabla. Con teclado, enfoca la región para recorrer su contenido. Las causas son hipótesis que hay que contrastar, no diagnósticos automáticos.
Qué comprobar antes de ampliar el servidor
Lo que observas
Evidencia que falta
Primer cambio a probar
El HTML tarda, también con poco tráfico
Desglose de conexión y espera, tiempos de aplicación, consultas y llamadas externas.
Corregir la dependencia lenta o configuración detectada; no atribuir todo el TTFB a la máquina.
La página pública va bien, buscar o comprar tarda
Diferencia entre rutas cacheadas y dinámicas, consulta ejecutada y espera en cada servicio.
Optimizar la ruta dinámica con el responsable de la aplicación; no cachear contenido privado indiscriminadamente.
El HTML llega pronto, la portada tarda en verse
Elemento LCP, inicio de su descarga, tamaño y momento de presentación.
Ajustar entrega o presentación del recurso identificado, conservando calidad y funcionamiento.
Solo falla durante campañas
Concurrencia, errores, tiempos y métricas del servidor recogidos durante el mismo intervalo.
Ensayo controlado de capacidad o ajuste del cuello concreto; comprobar límites del plan.
Solo algunos usuarios esperan
Dispositivo, red, región, VPN, versión y ruta afectada.
Reproducir esas condiciones antes de cambiar infraestructura para todos.
La página aparece pero no responde al tocar
Actividad del navegador e interacción exacta que se bloquea.
Revisar trabajo de scripts e interacción; más memoria del VPS no equivale a más capacidad del teléfono.
Una comprobación inicial sin tocar el servidor
Abre una página pública de tu sitio en una sesión de prueba y anota las condiciones.
En las herramientas de desarrollo del navegador, abre Network/Red, recarga y localiza el documento HTML. Revisa sus tiempos y las solicitudes que se demoran. No cambies configuraciones de producción.
Identifica si la espera ocurre al conectar, antes de recibir respuesta o durante una descarga. La referencia oficial de Chrome DevTools explica las fases del panel.
Guarda una captura o un resumen sin cookies, tokens ni datos personales. Un archivo de red puede contener información sensible: no lo publiques ni lo envíes sin revisarlo.
Repite bajo las mismas condiciones y registra la variación. Un valor aislado no distingue una incidencia puntual de un comportamiento repetido.
Para profundizar en el contenido principal, la guía de optimización de LCP propone separar la llegada del HTML, la espera para solicitar el recurso, su descarga y su presentación. Ese desglose evita corregir una parte pequeña mientras otra sigue dominando la espera.
3. Ejemplo: por qué duplicar recursos puede no resolverlo
Ejemplo hipotético, no medición de este sitio ni promesa de resultado. Supón una visita cuya presentación principal tarda 4.0 segundos. Para ilustrar el diagnóstico se descompone en 0.4 s hasta el HTML, 1.2 s de espera para solicitar el recurso principal, 0.8 s de descarga y 1.6 s hasta presentarlo: 0.4 + 1.2 + 0.8 + 1.6 = 4.0 s.
Si solo se redujera a la mitad el primer tramo, manteniendo los demás iguales, el total sería 0.2 + 1.2 + 0.8 + 1.6 = 3.8 s: una reducción de 0.2 s, equivalente al 5% del total inicial. Esta cuenta no predice el efecto de un VPS; muestra por qué conviene localizar la espera dominante antes de gastar.
En un caso distinto, la demora podría estar concentrada en la aplicación y coincidir con agotamiento de capacidad. Entonces sí tendría sentido un piloto de recursos adicionales. En ambos casos debes volver a medir el resultado completo: cambiar un componente puede desplazar el cuello de botella o alterar los demás tiempos.
No confundas una mejora con una comparación desigual
No compares una primera visita sin caché con otra ya cacheada sin señalarlo.
No cambies simultáneamente servidor, tema, plugins e imágenes si pretendes atribuir el resultado a uno solo.
No borres los intentos lentos o fallidos del registro. Reporta cuántas pruebas hubo y qué condiciones cambiaron.
No traslades una prueba local favorable a todos los usuarios ni a cualquier volumen de tráfico.
4. Cuándo sí vale la pena probar un VPS
Una prueba de VPS es razonable cuando necesitas una configuración no disponible en el servicio actual, la carga exige capacidad que el plan no entrega o la evidencia apunta a una limitación de infraestructura que puedes corregir. Pide datos sobre CPU, memoria, almacenamiento, red y límites de uso; “recursos dedicados” puede tener alcances distintos según la oferta.
La prueba debe responder una pregunta concreta, por ejemplo: “¿esta configuración reduce la espera de búsqueda bajo la concurrencia acordada sin aumentar errores?”. Define antes el resultado aceptable y qué obligaría a rechazarla. No existe un número universal de visitas que determine el salto a VPS: importan las tareas, datos, concurrencia y arquitectura.
Replica lo necesario en un entorno autorizado. Usa versiones y un conjunto de datos representativo, anonimizado cuando corresponda. Desactiva o aísla efectos externos como correos, cobros y documentos reales.
Establece una línea base comparable. Misma tarea, configuración de prueba, caché, red y conjunto de datos. Si alguna condición no puede igualarse, anótala como limitación.
Cambia lo mínimo para evaluar la hipótesis. Conserva el registro de configuración anterior y posterior. Las pruebas de carga requieren autorización, límites y una ventana acordada; no satures producción para “ver hasta dónde aguanta”.
Verifica función además de tiempos. Comprueba datos, sesiones, formularios, búsqueda y permisos. Documenta resultados y errores con quien conoce el negocio.
Decide y prepara retorno. Si no mejora lo que justificaba el cambio, no compenses el fracaso con una métrica secundaria. Si sí mejora, planifica copia, sincronización, validación y reversión antes de migrar.
5. Operación, seguridad y crecimiento también cuestan
El control de un VPS permite personalizar componentes, pero también exige administrar sistema y aplicación. Aclara quién aplica parches, observa alertas, restaura copias y responde a incidentes. Un servicio administrado puede aportar valor si esas tareas, horarios y exclusiones están por escrito; no implica resolución inmediata de cualquier problema.
La ampliación de CPU, RAM o disco puede requerir reinicio o migración y no siempre elimina el cuello de botella. Solicita límites, ventanas y costos. Incluye licencias, respaldos y tiempo de operación al comparar propuestas. Un entorno de pruebas tampoco garantiza aislamiento si comparte los mismos recursos o envía acciones reales: delimita sus accesos y dependencias.
Ubicar el servicio cerca del público puede ser una parte de la evaluación de red, pero no reemplaza medir desde las conexiones reales. Un centro de datos anunciado en México no demuestra por sí solo que todas las transacciones sean más rápidas.
Mide el efecto que te importa: tareas terminadas, errores, experiencia y, cuando tengas datos suficientes, resultados comerciales. No atribuyas una variación de ventas o búsquedas a la migración sin considerar campañas, contenido, temporada y otros cambios concurrentes.
Ficha reutilizable: una hipótesis por cambio
Copia este formato a tu documento de trabajo. No captura datos ni ejecuta pruebas desde esta página.
URL y tarea: ____ Usuario, dispositivo, red y fecha: ____ Estado de sesión y caché: ____ Síntoma y evidencia inicial: ____ Hipótesis: ____ Cambio único propuesto: ____ Resultado mínimo aceptable y errores no tolerados: ____ Pruebas realizadas y variación: ____ Resultado funcional: ____ Limitaciones de la comparación: ____ Decisión, responsable y procedimiento de retorno: ____
IA para ordenar el diagnóstico, no para inventarlo
Un asistente puede ayudarte a agrupar síntomas o preparar preguntas a partir de un resumen anonimizado. Pídele distinguir observaciones, hipótesis y datos faltantes. No subas cookies, claves ni registros completos sin revisar su contenido. Una explicación plausible no demuestra la causa: contrasta las sugerencias con documentación y pruebas controladas; no ejecutes cambios de configuración solo porque los propone la IA.
¿Un VPS garantiza que mi web cargue en menos de tres segundos?
No. El tiempo depende de la aplicación, recursos, red, navegador y tarea. Una oferta debe evaluarse con condiciones definidas; una cifra universal no sustituye la medición.
¿Debo migrar si PageSpeed muestra una puntuación baja?
No automáticamente. Revisa los diagnósticos y determina si apuntan a respuesta del backend, entrega de recursos o trabajo del navegador. La puntuación por sí sola no identifica el componente que conviene cambiar.
¿Más RAM siempre mejora una tienda?
No. Puede ayudar cuando la falta de memoria es la limitación demostrada. No corrige por sí sola una dependencia externa, un recurso visual tardío o una consulta mal planteada.
Solicita un diagnóstico con evidencia
Si necesitas apoyo, comparte con Cobalt tu ficha de diagnóstico, sin accesos ni datos privados. Pide que la propuesta vincule el cambio con una prueba y un responsable. La misma ficha sirve con tu equipo o con otro proveedor; si la evidencia apunta al sitio y no al servidor, optimizar antes de migrar puede ser la decisión correcta.
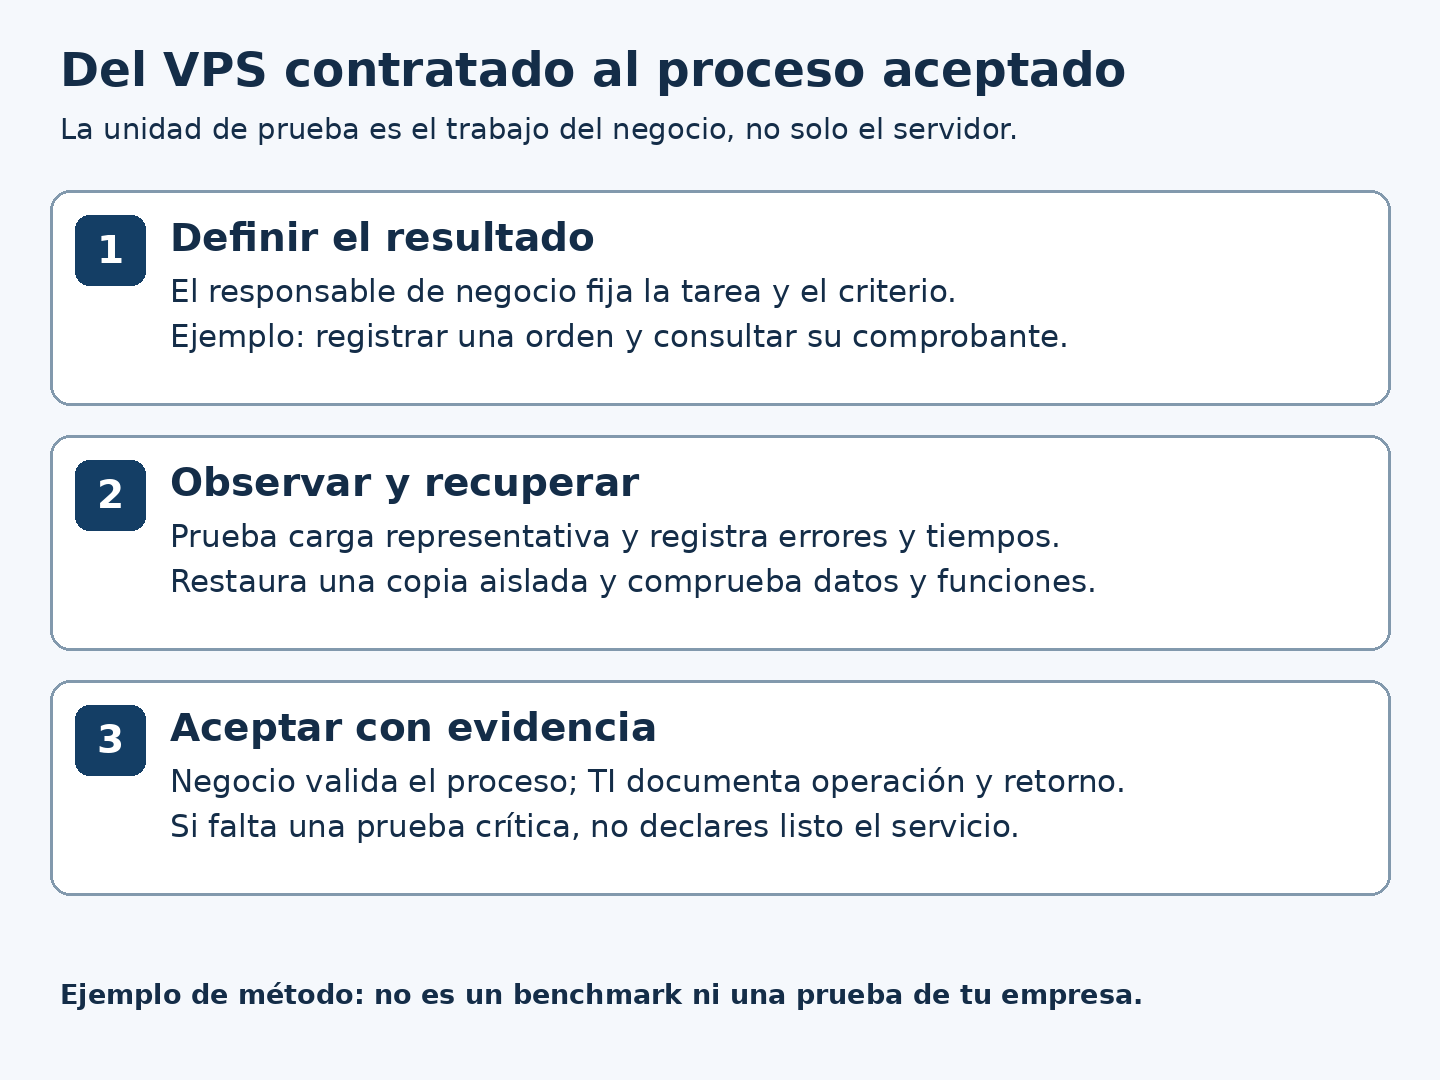
El VPS adecuado para tu empresa en México es el que permite completar tu trabajo real, recuperarlo cuando algo falla y saber quién debe intervenir. La cantidad de RAM o la ubicación anunciada no bastan para demostrarlo. Antes de contratar, convierte tu operación en una ficha de requisitos y acuerda cómo se comprobará cada uno.
Esta guía está pensada para quien debe aceptar el servicio —dirección, administración o responsable de TI— y necesita coordinar al proveedor del servidor con quien mantiene el sistema. El resultado será un expediente breve para decidir aceptar, corregir o descartar, no una lista de especificaciones compradas a ciegas.
La decisión en cuatro pasos
Describe tres tareas sin las cuales tu empresa no puede trabajar.
Asigna una prueba, un resultado esperado y un responsable a cada tarea.
Comprueba recuperación y soporte, además de velocidad.
Acepta solo lo demostrado; deja pendientes y exclusiones por escrito.
No necesitas un VPS si tu aplicación en modalidad SaaS ya cubre el trabajo, o si un hosting administrado resuelve un sitio sencillo sin exigir administración del sistema operativo. Tampoco hace falta contratar más capacidad si el problema está en una consulta, la conexión de la oficina o una integración externa.
Diagrama original de apoyo; sus criterios se desarrollan en el texto. Ampliar diagrama.
1. Describe el negocio antes de pedir CPU y memoria
Un VPS es una máquina virtual con una asignación de recursos. La política de CPU, almacenamiento y límites depende del servicio: no supongas que todo recurso es físicamente exclusivo ni que más vCPU arreglarán cualquier lentitud. Para comparar modelos de infraestructura, consulta VPS, cloud y servidor dedicado. Aquí nos concentraremos en comprobar que una propuesta sirve para tu operación.
Copia esta ficha a un documento interno y complétala con el usuario del sistema y su responsable técnico. Si algo no se conoce, escribe “pendiente de medir”, no cero.
Ficha reutilizable de operación
Sistema: nombre, versión, sistema operativo, motor de base de datos y responsable de compatibilidad.
Tres tareas críticas: por ejemplo, registrar una venta, consultar existencias y cerrar un reporte; define qué significa terminarlas correctamente.
Uso simultáneo: personas activas al mismo tiempo, desde qué oficinas o conexiones y en qué horario de mayor carga.
Datos: tamaño actual, crecimiento observado y archivos necesarios para que la aplicación funcione; distingue datos de respaldos.
Dependencias: internet de las oficinas, licencias, impresoras, servicios externos, envío de correo y tareas programadas.
Interrupción tolerable: cuánto tiempo puede quedar detenido cada proceso y qué alternativa manual existe.
Pérdida tolerable: qué registros podrían reconstruirse y desde qué comprobantes.
Responsables: quién autoriza cambios, quién administra el servidor y quién valida la aplicación.
Para ERP y contabilidad, confirma con el fabricante o integrador versiones y licencias soportadas antes de instalar. Para una tienda, incluye compra de prueba en modo autorizado, inventario y notificaciones. Para una plataforma educativa, prueba una sesión completa y la entrega de un archivo. Para un servicio propio, agrega sus dependencias y tareas de mantenimiento. Ningún número universal de “usuarios por VPS” sustituye estas condiciones.
2. Convierte cada promesa en una prueba de aceptación
La siguiente matriz es una plantilla propuesta, no un benchmark ni una certificación. Acuerda valores con tu equipo y el proveedor antes de ejecutar las pruebas. Usa un entorno autorizado, cuentas de prueba y datos sintéticos o anonimizados; no hagas pruebas destructivas sobre producción.
En móvil, la tabla se desplaza horizontalmente. Cada fila relaciona una necesidad con su evidencia y la decisión que permite tomar.
Matriz: necesidad → comprobación → decisión
Necesidad
Prueba y evidencia que debes guardar
Cuándo aceptar o corregir
La aplicación completa el trabajo
Ejecuta las tres tareas críticas con la versión acordada. Anota resultado, errores, dependencias y quién lo validó.
Acepta cuando el responsable funcional confirma el resultado; iniciar sesión por sí solo no basta.
Responde durante el pico
Repite el mismo recorrido con la concurrencia pactada. Guarda hora, origen de conexión, duración de tareas y métricas del servidor durante la prueba.
Compara con el límite de negocio acordado. Si falla, identifica si el cuello está en aplicación, disco, CPU, memoria o red antes de ampliar.
Se puede recuperar el trabajo
Restaura una copia en un entorno separado; registra inicio, servicio utilizable, fecha del último dato recuperado y validación funcional.
Corrige si solo hay un archivo de respaldo sin restauración demostrada, o si el resultado no cumple los objetivos acordados.
Alguien atiende una falla
Revisa canales, horarios, severidades, escalamiento, exclusiones y responsable por capa. Acuerda un ejercicio de comunicación, sin fingir una emergencia.
“Ticket recibido” no equivale a “servicio recuperado”. Aclara ambos hitos y cómo se informa el avance.
Los accesos tienen dueño
Comprueba cuentas individuales, acceso administrativo limitado, mecanismo de revocación y quién conserva el inventario de permisos.
No aceptes credenciales compartidas sin control de responsables ni un acceso que nadie pueda revocar.
Se puede crecer o salir
Documenta cómo ampliar recursos, interrupción prevista, respaldo previo y cómo exportar datos, configuraciones y licencias aplicables.
Aclara costos y límites. Una ampliación posible no significa ampliación inmediata ni sin reinicio.
Ubicación en México: mide el recorrido completo
La prueba relevante es desde donde trabaja tu personal, no desde la computadora del vendedor. Pide identificar la región del servicio y repite el mismo recorrido de la aplicación desde las oficinas o conexiones representativas, en horarios comparables. Registra también el proveedor de internet y cualquier VPN utilizada.
El tiempo de una operación incluye más que la distancia al centro de datos. Una medición de ping puede orientar sobre la red, pero no demuestra cuánto tarda un reporte o una transacción. No descartes automáticamente una ubicación ni la des por ganadora por su país: conserva la evidencia de la tarea completa.
Recuperación: dos objetivos distintos
RTO expresa cuánto tiempo de interrupción se tolera hasta recuperar el servicio; RPO, cuánto retroceso de datos es aceptable. Deben partir del impacto en tu negocio y sus dependencias, no de un valor copiado de otra empresa. AWS explica cómo definir estos objetivos de recuperación.
Un respaldo no es una prueba de recuperación. Tampoco la palabra “cloud” convierte un servidor aislado en una aplicación de alta disponibilidad: deben contemplarse sus datos, red y dependencias. La documentación de confiabilidad de máquinas virtuales de Microsoft distingue estos componentes. Si el negocio no tolera la recuperación medida, revisa el diseño; no lo resuelvas cambiando el texto del contrato.
Ensayo de una jornada: del pedido al reporte
Para un ERP, elige con su integrador una empresa de prueba y un recorrido que represente el trabajo diario. Esta secuencia propuesta debe adaptarse al sistema; no autoriza emitir documentos fiscales reales ni cargos.
Prepara el punto de partida. Registra versión, inventario de prueba, perfiles autorizados y valores esperados. Comprueba que las integraciones externas estén en modo de pruebas o desconectadas de forma acordada.
Recorre el proceso. Un usuario registra un pedido de prueba, otro consulta su efecto y el responsable genera el reporte correspondiente. Verifica importes, estados y permisos contra los valores iniciales; no solo que aparezca una pantalla.
Repite en condiciones representativas. Mantén los mismos datos y acciones, añade la concurrencia acordada y anota duración y errores. Si introduces otro conjunto de datos, registra la diferencia para no comparar escenarios distintos.
Ensaya la recuperación separada. Desde la copia autorizada, vuelve a abrir el sistema restaurado y comprueba los mismos registros con el responsable funcional. Evita que esa instancia envíe correos, cargos o documentos reales.
Firma el resultado por tarea. El integrador confirma compatibilidad, el administrador identifica limitaciones y la persona dueña del proceso decide si el resultado permite trabajar. Un dato incorrecto detiene la aceptación aunque el tiempo de respuesta sea bueno.
Guarda un registro por ejecución: fecha, configuración, origen de conexión, participantes, datos de prueba, duración, resultado esperado, resultado observado y evidencia sin secretos. Un piloto satisfactorio bajo esas condiciones no demuestra capacidad ilimitada ni disponibilidad futura.
3. Ejemplo: aceptar con condiciones o posponer
Escenario hipotético, no mediciones de un cliente. Una distribuidora define que su sistema debe volver a estar utilizable en hasta 120 minutos y perder, como máximo, 30 minutos de registros. El equipo acuerda probar una restauración completa antes de migrar.
En el ejercicio supuesto, el servicio vuelve a ser utilizable después de 95 minutos: cumple el objetivo de tiempo de ese escenario.
La copia recuperada es de 4 horas antes del incidente simulado: no cumple la tolerancia de 30 minutos de datos.
Decisión: no aceptar todavía la recuperación. Revisar frecuencia, consistencia y proceso de copias, y repetir la prueba. Que el servidor sea rápido o barato no compensa ese incumplimiento.
Si el proceso pudiera reconstruirse íntegramente con otra fuente y el negocio aceptara ese esfuerzo, la decisión podría cambiar. Debe validarlo quien responde por la operación; no el equipo técnico por su cuenta. Los objetivos de este ejemplo no son recomendaciones universales ni compromisos de un proveedor.
4. Administrado no significa “todo incluido”
Separar infraestructura de sistema operativo y aplicaciones ayuda a encontrar responsabilidades sin huecos. El modelo de responsabilidad compartida de AWS ilustra esta distinción; los servicios y contratos concretos cambian quién realiza cada tarea.
Antes de aceptar, asigna por escrito un responsable y un suplente para: actualizaciones del sistema, monitoreo y alertas, respaldo y restauración, base de datos, soporte funcional de la aplicación y comunicación de incidentes. Si dos proveedores participan, define quién abre el caso con el otro y quién coordina hasta cerrar el problema.
Un socio administrado puede justificar un precio mayor cuando asume estas tareas con alcance verificable y tu empresa no tiene personal disponible para realizarlas. No sustituye al dueño del proceso ni garantiza que toda falla se resolverá en minutos. Un servicio autogestionado puede ser razonable si tu equipo tiene capacidad, cobertura y procedimientos probados; no es un error elegirlo por presupuesto.
Compara el costo completo de la misma operación: servidor, licencias, administración, respaldos, restauraciones, almacenamiento adicional, transferencia cuando aplique, migración y tiempo del personal. Solicita moneda, impuestos, renovación, exclusiones y condiciones de salida por escrito. No sumes una tarifa promocional mensual a un soporte anual sin convertir ambos al mismo período.
5. Cierra con un acta de entrega, no con “ya quedó”
Este formato puede copiarse a tu documento de aceptación. No captura ni envía información desde esta página.
Servicio y fecha: [identificación de la propuesta y versión]. Operación validada: [tareas, usuarios y condiciones]. Evidencia: [registro de pruebas y ubicación interna]. Recuperación: [objetivos acordados y resultados observados]. Responsables: [infraestructura, aplicación y autorización del negocio]. Pendientes: [impacto, responsable, fecha y condición de cierre]. Decisión: [aceptar / aceptar solo aspectos expresamente delimitados / no aceptar]. Próxima comprobación: [evento o fecha acordada].
Conserva una copia accesible para la empresa, además de la del proveedor. Repite las pruebas afectadas si cambia la versión del sistema, la capacidad, el esquema de respaldo o una dependencia crítica. Una validación de hoy no acredita cualquier configuración futura.
Cómo puede ayudar la IA sin decidir por tu empresa
Un asistente puede ayudarte a convertir una lista de tareas en preguntas para el proveedor o a detectar campos vacíos en esta ficha. Trabaja con descripciones anonimizadas y exige que distinga datos conocidos de supuestos. Puede inventar compatibilidades o interpretar mal un compromiso: contrasta cada conclusión con documentación, contrato y prueba real.
No compartas contraseñas, bases de clientes, datos de nómina ni bitácoras completas sin autorización y evaluación del tratamiento de datos. La aprobación de una migración, la aceptación del servicio y la ejecución de cambios siguen a cargo de responsables humanos. La IA no observa tu VPS ni verifica una restauración por el solo hecho de describirla.
¿Tengo que mover todo para probar?
No necesariamente. Acuerda un piloto delimitado con datos de prueba y una lista de dependencias. Si necesitas información real, define previamente acceso, protección y eliminación de la copia. No cambies producción ni desactives el servicio anterior hasta tener un plan de corte y retorno aprobado.
¿Un VPS es obligatorio para que una empresa mexicana opere?
No. La infraestructura debe responder a la aplicación y a la operación, no a una etiqueta. Una solución SaaS, hosting administrado o infraestructura propia puede ser adecuada. Los requisitos específicos de tu software y de tu actividad deben revisarse por separado; esta guía no constituye una certificación de cumplimiento.
Solicita una propuesta que puedas comprobar
Si necesitas apoyo, comparte tu ficha sin secretos al consultar los VPS administrados de Cobalt. La oferta pública distingue infraestructura y soporte del software empresarial; confirma en tu propuesta licencias, horarios, responsabilidades y pruebas de entrega. También puedes usar la ficha con otro proveedor: el objetivo es saber qué estás aceptando.
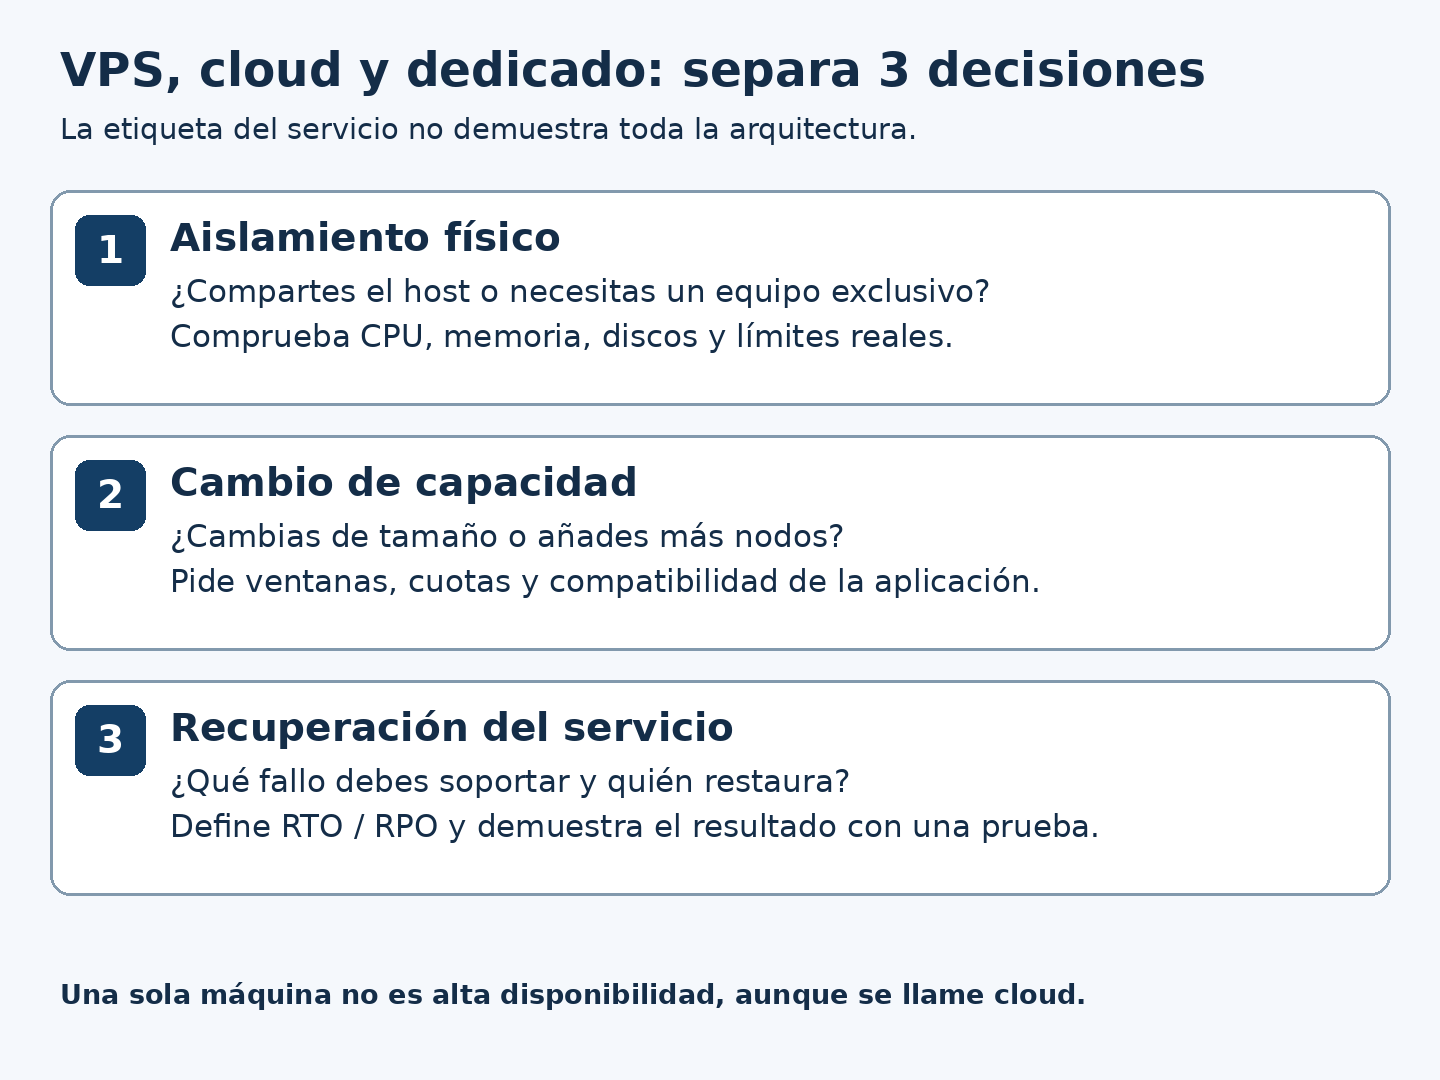
Elegir entre VPS, cloud y servidor dedicado no consiste en ordenar tres productos de menor a mayor calidad. Un VPS describe una máquina virtual; cloud describe un modelo de provisión y servicios; dedicado describe el uso exclusivo de un servidor físico. Por eso una máquina virtual cloud también puede cumplir el papel de un VPS, y una infraestructura cloud puede ofrecer hardware dedicado.
La decisión útil es otra: qué necesita tu aplicación, cómo crecerá y cómo seguirá operando cuando algo falle. Esta guía permite separar esas preguntas, comparar propuestas equivalentes y documentar una elección. No sustituye una prueba de tu aplicación ni garantiza un plazo de migración.
Tres dimensiones distintas, no tres niveles de calidad
Antes de pedir una cotización, separa aislamiento físico, forma de ampliar capacidad y recuperación ante fallos. Una etiqueta comercial no demuestra las tres.
Diagrama original de apoyo; sus criterios se desarrollan en el texto. Ampliar diagrama.
Aislamiento: ¿quién comparte el equipo físico?
En un VPS habitual compartes el host con otras máquinas virtuales. La asignación de CPU, memoria, almacenamiento y sus límites depende de la oferta. En un dedicado se reserva el equipo físico, pero eso no elimina los límites de red, discos ni aplicación.
Elasticidad: ¿cómo cambia la capacidad?
Ampliar una VM puede requerir detenerla o reiniciarla. Añadir más servidores exige que la aplicación distribuya trabajo y datos correctamente. “Cloud” no significa que cualquiera de esas operaciones sea automática, instantánea o ilimitada.
Continuidad: ¿qué sucede si se pierde un componente?
Un servidor único puede ser un punto único de fallo, sea virtual o físico. Diseña recuperación, responsables y pruebas por separado de la compra de capacidad.
En una pantalla estrecha puedes desplazar las tablas horizontalmente. Con teclado, enfoca la región de la tabla para recorrer su contenido.
Preguntas para comparar propuestas concretas
Criterio
VPS de plan definido
Infraestructura cloud
Servidor físico dedicado
Encaje inicial
Una aplicación compatible que cabe en una VM y necesita control del sistema.
Necesitas combinar cómputo, red, datos y automatización según una arquitectura definida.
Necesitas un perfil físico concreto o aislamiento de host que justifique operarlo.
Cómo comparar recursos
CPU compartida o reservada, RAM, IOPS, red y límites del plan.
Familia de instancia, discos, servicios y cuotas de cada componente.
CPU, memoria, discos, redundancia y procedimiento de sustitución física.
Crecimiento
Cambio de plan o migración; pide ventana y límites.
Cambio de tamaño o más instancias, sujeto a diseño, capacidad y cuotas.
Ampliación de hardware o más equipos; pide disponibilidad y plazo.
Operación
Autogestionada o contratada; especifica tareas.
Puede reducir ciertas tareas con servicios gestionados, no toda responsabilidad.
Incluye sistema y aplicación; separa soporte físico del soporte del software.
Continuidad
Una VM no demuestra recuperación probada.
Una VM en una zona no equivale a una aplicación multizona.
Un equipo exclusivo no equivale a un segundo equipo disponible.
Costo a revisar
Plan, licencias, respaldos, administración y ampliaciones.
Cómputo, datos, red, servicios, observabilidad y operación.
Renta o compra, licencias, administración, respaldos y contingencia.
Ruta de decisión: descarta primero lo incompatible
Comprueba las restricciones del software. Documenta sistema operativo, versión de base de datos, arquitectura de CPU, licencias y soporte del fabricante. Si exige hardware exclusivo o una configuración que el proveedor no ofrece, descarta esa opción aunque sea más barata.
Describe la carga, no solo las visitas. Registra concurrencia, trabajo por operación, tamaño de datos, tareas programadas y horas pico. Un portal con consultas costosas puede exigir más que otro con más visitantes y contenido estático.
Define cuánto puedes parar y perder. RTO es el objetivo de tiempo para recuperar el servicio; RPO, la pérdida de datos máxima tolerable expresada en tiempo. Son objetivos que hay que probar, no propiedades automáticas de un plan.
Elige el cambio de capacidad que realmente necesitas. Si crecer de forma planificada basta, evalúa una VM y su ruta de ampliación. Si necesitas repartir tráfico entre nodos, verifica sesiones, archivos, base de datos y dependencias antes de pagar por más instancias.
Confirma quién operará. Si nadie puede atender parches, alertas, recuperación y cambios, incorpora administración al presupuesto o evalúa un servicio de aplicación gestionado. Comprar root no crea una capacidad operativa.
Tres casos que llevan a decisiones diferentes
ERP interno con carga relativamente estable: empieza por compatibilidad del fabricante, concurrencia real, disco y recuperación. Una VM puede ser suficiente; no se justifica dedicado por el solo hecho de ser una empresa. Acepta la opción únicamente tras el piloto y con una ruta documentada de crecimiento.
Tienda con campañas: diferencia un pico de CPU de un bloqueo en base de datos o pasarela. Añadir nodos web no corrige por sí solo esas dependencias. Cloud puede facilitar componentes escalables, pero la aplicación y el equipo deben poder utilizarlos.
Proceso con necesidad física específica: compara dedicado o una oferta de host exclusivo, revisa licenciamiento y mide la carga. El aislamiento puede ser relevante sin que sea la alternativa más económica ni la más disponible.
Son criterios de diseño, no benchmarks ni recomendaciones de tamaño. Si todavía no conoces la carga, la siguiente inversión útil es una prueba representativa, no contratar capacidad a ciegas.
Cloud no convierte una sola máquina en alta disponibilidad
La documentación de fiabilidad de Azure Virtual Machines distingue la protección de una VM de la resiliencia de toda la aplicación. Distribuir instancias entre zonas requiere tratar también los datos, el balanceo y la conmutación. No basta con contratar dos máquinas.
Además, replicar no sustituye un respaldo: una eliminación o corrupción puede propagarse. La guía de recuperación de AWS compara estrategias de distinta complejidad y pide probar la recuperación. Define qué fallo cubrirás: equipo, zona, cuenta comprometida o pérdida de datos. No todas las arquitecturas cubren todos esos escenarios.
Compara el costo total: un ejemplo que puedes recalcular
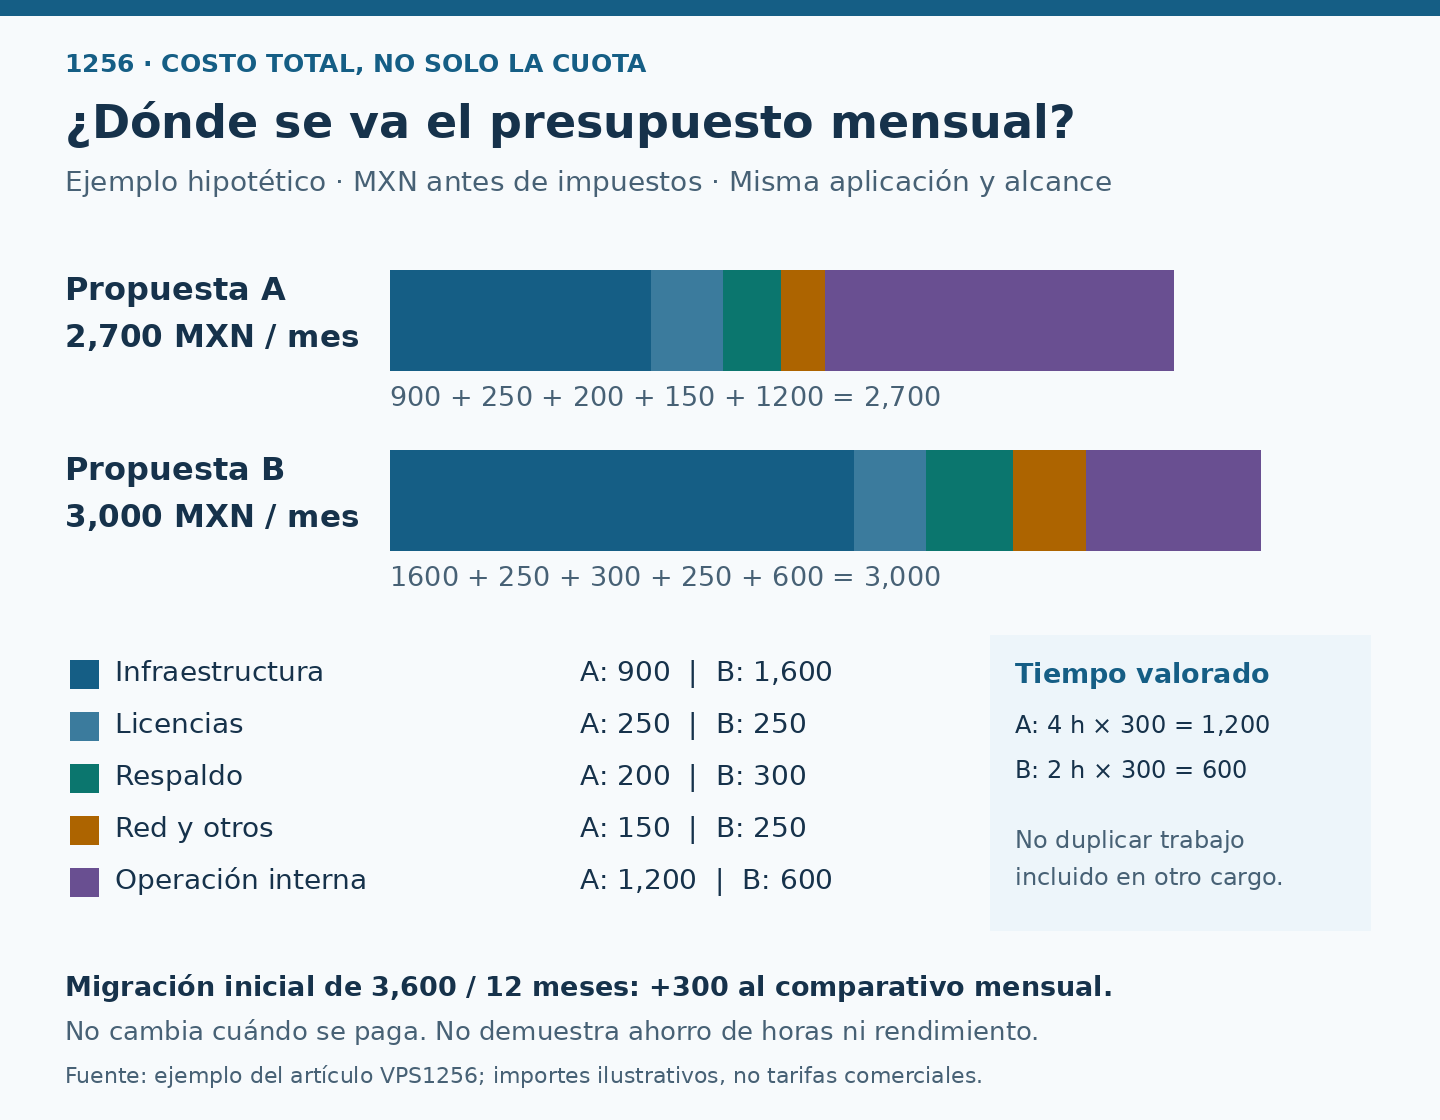
Ejemplo ilustrativo, no cotización ni precio de mercado. Supón dos propuestas para la misma aplicación y una valoración interna de trabajo de 300 MXN por hora. Todas las cantidades siguientes son supuestos antes de impuestos; no describen tarifas de un proveedor.
Escenario mensual hipotético en MXN, antes de impuestos
Concepto
Propuesta A
Propuesta B
Infraestructura
900
1,600
Licencias
250
250
Respaldo independiente
200
300
Red y otros servicios
150
250
Operación valorada a 300/h
4 h × 300 = 1,200
2 h × 300 = 600
Total mensual comparable
2,700
3,000
Fórmula: infraestructura + licencias + respaldos + red y otros servicios + horas de operación × valor de la hora. Una migración inicial de 3,600 MXN, repartida para esta comparación entre 12 meses, añade 300 MXN mensuales a cada propuesta si cuesta lo mismo en ambas: los totales comparables serían 3,000 y 3,300 MXN. No cambia el flujo real del pago inicial.
Ejemplo ilustrativo antes de impuestos, no tarifas comerciales. La tabla anterior contiene cada importe. Prorratear una migración de 3,600 MXN en 12 meses añade 300 MXN a cada alternativa si cuesta lo mismo en ambas; no cambia cuándo se paga. Abre la imagen para ampliarla.
Compara tus costos con tus propios datos
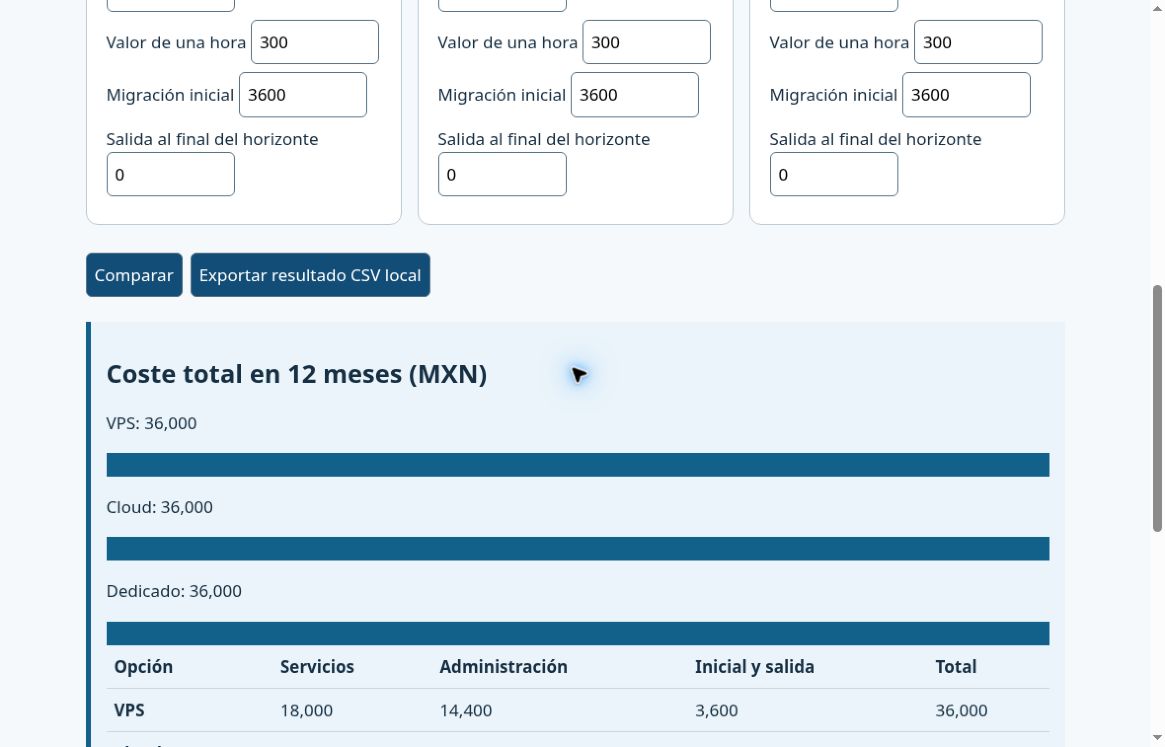
Abre la herramienta para introducir tus importes, desglosar el costo total de VPS, cloud y dedicado durante el periodo elegido y exportar el resultado como CSV local. Los cálculos se realizan en tu navegador: la herramienta no envía los datos introducidos a un servidor.
Los valores iniciales son hipotéticos, no una cotización. La selección de moneda cambia la etiqueta, no convierte divisas; usa importes en una misma moneda y revisa qué conceptos incluye cada propuesta.
Captura de la herramienta con un escenario hipotético, distinto del ejemplo de la tabla anterior. La imagen no es un formulario: ábrela para entrar al comparador y editar tus datos.
En este supuesto B cuesta 300 MXN más al mes, pero deja de ser más cara si A requiere más de una hora adicional de operación mensual: con 5 horas A empata en 3,000 MXN, sin prorratear migración. Esto no demuestra que B ahorre horas: pide evidencias del alcance y usa tus registros. Repite el cálculo con consumo pico, restauraciones, licencias adicionales, egreso de datos, impuestos, moneda y renovación de cada oferta. No sumes trabajo ya incluido dos veces.
Las alertas de gasto ayudan a detectar desviaciones; no asumas que detendrán automáticamente todos los cargos. Define quién las revisará y qué acción puede tomar sin interrumpir una operación crítica.
Prueba la opción antes de comprometer la migración
Prepara una copia aislada autorizada. Protege o anonimiza datos, impide correos y cobros reales, y conserva intacta la producción. Usa versiones y tamaño de datos comparables.
Ejecuta tareas que importan al negocio. Por ejemplo, consultar existencias, guardar una orden y obtener un reporte. Define antes el tiempo aceptable y la concurrencia; registra resultados y errores, no solo un promedio de CPU.
Observa el cuello de botella. CPU, memoria, almacenamiento, red o servicio externo pueden limitar de manera distinta. Si falla la prueba, identifica la causa antes de subir de plan.
Restaura en un entorno separado. Comprueba registros, archivos, configuración, acceso y funciones. Cronometra hasta que el servicio sea utilizable, no hasta que termine de copiarse el respaldo.
Ensaya cambio y retorno. Define congelación de escrituras cuando proceda, sincronización final, validación, responsables y condiciones de reversión. Bajar TTL por sí solo no evita pérdida de datos ni garantiza cero interrupción.
Solo acepta una propuesta si satisface tus criterios de funcionamiento, recuperación y operación. El modelo de responsabilidad compartida de AWS ilustra por qué contratar infraestructura no transfiere automáticamente la gestión de la aplicación. Para un servicio administrado, exige por escrito qué tareas asume cada parte.
Ficha reutilizable para documentar la decisión
Copia esta ficha en tu documento de evaluación; no se envía ni se guarda desde esta página. Sirve para autogestión o para comparar cualquier proveedor.
Aplicación y proceso crítico: ____ Versiones y licencias compatibles: ____ Carga probada y fecha: ____ Tiempo aceptable por operación y errores permitidos: ____ RTO / RPO aprobados por negocio: ____ Aislamiento físico necesario y motivo: ____ Ruta de ampliación y ventana: ____ Responsable de parches / alertas / restauración: ____ Costo mensual normal / pico / inicial: ____ Resultado de restauración y evidencia: ____ Condición que impide contratar: ____ Opción elegida, motivo y fecha de reevaluación: ____
Cómo puede ayudar la IA, y dónde no debe decidir
Una herramienta de IA puede ordenar requisitos, señalar campos vacíos en dos propuestas o ayudarte a formular preguntas sobre cargos y responsabilidades. Usa datos sin secretos ni información de clientes. No le delegues compatibilidad, cálculo final, interpretación contractual ni dimensionamiento: puede inventar límites, precios o capacidades. Verifica cada conclusión contra documentación vigente, contrato y mediciones propias.
Si necesitas apoyo, pide un alcance verificable
Un proveedor administrado aporta valor cuando se compromete con tareas concretas: revisión de compatibilidad, piloto, monitoreo con responsables, prueba de restauración y acompañamiento del cambio. La etiqueta “administrado” o “24/7” no demuestra que incluya todo eso; diferencia recepción de un ticket, primera respuesta y resolución.
Si quieres revisar tu caso con Cobalt Blue Web, comparte la ficha de requisitos por contacto, sin contraseñas ni respaldos de producción. Pide propuesta y exclusiones por escrito. También puedes usar la ficha con tu equipo o con otro proveedor: la decisión debe sostenerse en evidencias, no en la marca.
Preguntas frecuentes
¿Cloud siempre es más caro que un VPS?
No hay una regla universal. Compara una arquitectura equivalente, consumo, operación y recuperación durante el mismo periodo. Una tarifa base menor puede excluir componentes que la otra incluye.
¿Un dedicado elimina la necesidad de respaldos?
No. El uso exclusivo del equipo no protege por sí solo frente a borrado, corrupción, fallos o incidentes de la cuenta. Define copias recuperables y prueba su restauración.
¿Puedo pasar de VPS a cloud sin cambiar mi aplicación?
A veces puedes trasladarla a otra VM compatible. Aprovechar varios nodos o servicios gestionados puede exigir cambios de arquitectura. Valida licencias, datos, red y procedimiento de retorno antes del cambio.
Revender VPS puede ser un negocio viable si cobras por una operación que puedes sostener, no solo por añadir un porcentaje al servidor. Antes de ofrecer un paquete necesitas identificar quién administra cada capa, calcular soporte y recuperación, y confirmar por escrito que tu proveedor permite el modelo de reventa. Tener un VPS no te convierte automáticamente en proveedor de máquinas virtuales ni garantiza marca blanca.
Esta guía sirve a agencias y profesionales que quieren atender a sus propios clientes. Al terminar tendrás una cuenta de costos reutilizable, una matriz de responsabilidades y una prueba pequeña para decidir si lanzar, ajustar la oferta o mantenerte como integrador sin revender infraestructura.
Primero: ¿revendes servidores, alojamiento o administración?
Son negocios distintos. El cliente debe saber si recibe un VPS propio, una cuenta dentro de un servidor compartido o una aplicación administrada. La separación comercial no demuestra aislamiento técnico.
Tres modelos que no conviene vender como equivalentes
Modelo
Qué recibe el cliente
Qué debes comprobar
Reventa de VPS por cliente
Una máquina virtual asignada a su servicio, con los accesos pactados.
Permiso de reventa, aprovisionamiento, titularidad, licencias, límites y procedimiento de salida.
Alojamiento reseller sobre un servidor
Una cuenta de hosting; no necesariamente una máquina virtual independiente.
Cuotas, aislamiento, copias por cuenta, número de cuentas permitido y límites del panel.
Administración de infraestructura del cliente
Tu trabajo técnico; el cliente contrata la infraestructura directamente.
Permisos delegados, alcance, horas, accesos de emergencia y responsabilidad de pago.
Por ejemplo, cPanel describe sus cuentas reseller como cuentas que distribuyen recursos y administran otras cuentas de cPanel mediante permisos de WHM. Eso no equivale a crear VPS. No ofrezcas virtualización anidada, acceso root o recursos dedicados si tu producto y contrato no lo admiten.
Decisión rápida: si todavía no tienes demanda recurrente ni una forma de cubrir incidencias, empieza por la administración de infraestructura contratada por el cliente. Si necesitas vender un servicio completo bajo tu marca, prueba primero un alcance estrecho y repetible. Para proyectos muy distintos entre sí, un paquete único puede ocultar más trabajo del que simplifica.
Precio sostenible: suma costos antes de elegir un porcentaje
Calcula en una misma moneda y periodicidad. Separa cargos de alta, costos mensuales y extras por uso. Un importe desconocido no vale cero: márcalo pendiente y no cierres una cotización todavía. Si el proveedor factura en otra moneda, documenta el tipo de cambio utilizado y cuándo se revisará.
Infraestructura: servidor, almacenamiento adicional, tráfico e IP cuando se cobren aparte.
Herramientas: panel, facturación, monitoreo y licencias por servidor, usuario o cuenta.
Continuidad: respaldos externos, retención, pruebas de restauración y tiempo para atender un incidente.
Trabajo: altas, cambios, actualizaciones, soporte y coordinación con el proveedor.
Operación comercial: cobro, atención, administración y una parte razonable de costos comunes.
Las licencias cambian el costo conforme crece el negocio: revisa la unidad de cobro y las condiciones vigentes en la página oficial de licencias de WHMCS o en el sistema que elijas. No necesitas esa herramienta específica para comenzar; una operación pequeña puede usar procesos más sencillos si conserva trazabilidad y seguridad.
Ejemplo hipotético: el soporte cambia el resultado
Ejemplo hipotético, no cotización de CBW ni medición de clientes reales. Importes mensuales en MXN, sin impuestos trasladados al cliente. El trabajo propio se valora como costo; no desaparece porque no contrates a otra persona.
Cuenta mensual ilustrativa de un servicio
Concepto
Supuesto
MXN/mes
Infraestructura
Importe supuesto
800
Licencias y herramientas
Porción asignada al servicio
150
Respaldos y monitoreo
Importe supuesto
150
Soporte y mantenimiento
2 horas × 250 MXN/hora
500
Administración y costos comunes
Porción asignada
100
Costo total estimado C
Suma anterior
1,700
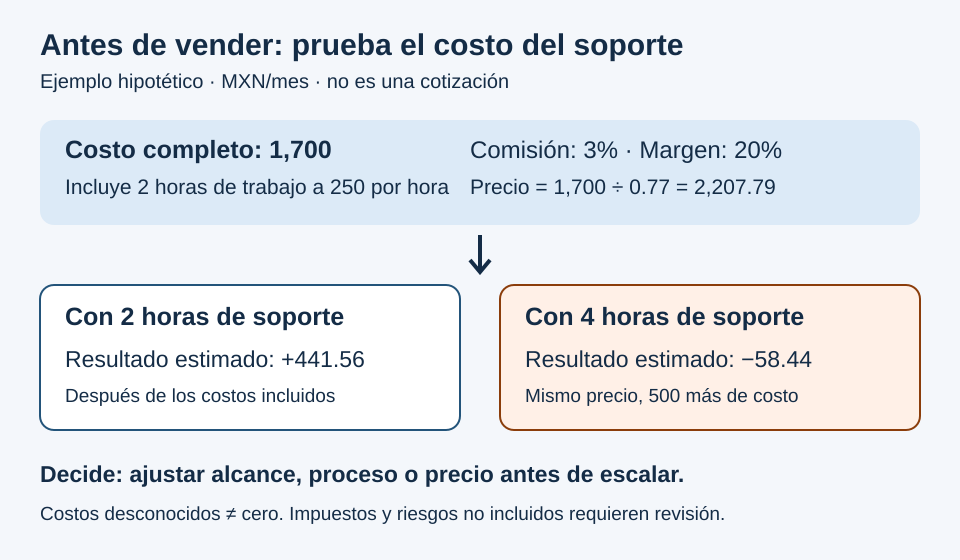
Supón además una comisión de cobro del 3% sobre el precio y un margen objetivo del 20% sobre ingresos, después de los costos incluidos. La fórmula es precio P = C ÷ (1 − comisión − margen). En este caso: 1,700 ÷ (1 − 0.03 − 0.20) = 2,207.79 MXN/mes, redondeado a centavos. La comisión sería 66.23 y el resultado estimado 441.56. No es utilidad neta después de todos los impuestos y riesgos; cualquier costo omitido reduce el resultado.
Si durante un mes el soporte sube de dos a cuatro horas, el costo aumenta a 2,200. Al mismo precio, después de la comisión quedarían −58.44 MXN. Esa diferencia no se resuelve diciendo que el servidor tenía un gran margen: requiere reducir trabajo repetitivo, ajustar alcance, cobrar extras acordados o cambiar el precio.
El recorrido del esquema es: anota costos conocidos, identifica comisiones, calcula un precio, prueba un mes con más soporte y decide si el alcance sigue siendo sostenible. Si faltan costos o el denominador de la fórmula es cero o negativo, el cálculo no da una cotización utilizable.
Margen y recargo no son lo mismo
Sin comisiones, comprar a 1,000 y vender a 1,300 implica un recargo del 30% sobre costo, pero un margen del 23.08% sobre venta: 300 ÷ 1,300. Para obtener 30% de margen con ese costo, el precio sería 1,000 ÷ 0.70 = 1,428.57. No existe un porcentaje universal que vuelva rentable cualquier servicio.
Plantilla de costos para copiar y completar
Servicio y cliente objetivo: ___. Moneda y periodo: ___. Infraestructura: ___. Licencias: ___. Respaldos y recuperación: ___. Horas ordinarias × costo/hora: ___. Administración asignada: ___. Otros costos: ___. Comisión de cobro: ___%. Margen objetivo: ___%. Costos todavía desconocidos: ___. Precio calculado: ___. Resultado con el doble de horas de soporte: ___. Alta o migración, por separado: ___. Fecha para revisar costos: ___.
No dupliques una licencia compartida en todos los servicios ni la omitas: reparte el costo con una regla explícita. Revisa el reparto si pierdes clientes; los costos fijos no se reducen automáticamente.
Vende un alcance que puedas demostrar
“Administrado” necesita una lista de tareas. “Soporte 24/7” debe distinguir recepción de tickets, respuesta humana y resolución. “Marca blanca” requiere confirmar qué verá el cliente en paneles, correos, facturas, soporte y comunicaciones de incidencias. No lo prometas basándote en una imagen comercial.
Matriz mínima antes de aceptar un cliente
Área
Pregunta que debe quedar respondida
Evidencia de aceptación
Acceso y seguridad
¿Quién administra usuarios, claves, actualizaciones y firewall?
Responsable, permisos mínimos y procedimiento de baja.
Aplicación
¿Quién corrige fallas del ERP, tienda o código?
Separación entre soporte de infraestructura y soporte funcional.
Respaldo
¿Qué datos se copian, dónde y durante cuánto tiempo?
Restauración aislada comprobada y registro del resultado.
Incidente
¿Quién recibe, clasifica, escala y comunica?
Canal, horario, contacto alterno y alcance por severidad.
Salida
¿Cómo recupera el cliente sus datos y accesos?
Formato, responsable, plazo y costos acordados.
La responsabilidad compartida de un proveedor de infraestructura muestra por qué contratar una máquina no transfiere automáticamente la protección de datos y aplicaciones. El reparto exacto depende de tu contrato; no traslades ese ejemplo a otro proveedor como si sus condiciones fueran iguales.
Un socio con operación y soporte definidos puede justificar un precio mayor cuando reduce tareas que tú no puedes cubrir, facilita escalaciones y documenta recuperación. Compara esos entregables, no solo CPU y memoria. Si cuentas con personal competente y procedimientos probados, administrar directamente puede ser una alternativa razonable.
Piloto de una oferta antes de abrir diez paquetes
Elige un caso limitado. Define aplicación, datos, horario y persona responsable. No uses información real del cliente en una prueba sin su autorización.
Valida el contrato mayorista. Confirma reventa, licencias, tratamiento de datos y qué acciones requieren intervención del proveedor. Si una condición no está clara, no la incluyas como promesa.
Documenta alta y entrega. Registra recursos contratados, accesos individuales y aceptación de funcionamiento. La evidencia debe permitir que otra persona continúe la operación.
Ensaya recuperación. Restaura en un entorno separado, comprueba archivos y aplicación, y registra qué faltó. No sobrescribas producción para demostrar que hay un respaldo.
Mide trabajo real del piloto. Anota minutos por tarea, incidencias y costos. Distingue esfuerzo inicial de mantenimiento recurrente; no extrapoles un mes tranquilo como garantía.
Toma una decisión. Lanza si puedes sostener alcance y precio; ajusta si el soporte absorbe el margen; pospón si faltan permisos, recuperación o responsables.
El alta rápida no acredita un servicio completo. Tampoco la escalabilidad técnica elimina por sí sola reinicios, migraciones, límites de licencia o pruebas de compatibilidad. Revisa cada cambio antes de ofrecerlo al cliente.
IA: ayuda a preparar, no a prometer ni ejecutar a ciegas
Un asistente de IA puede ayudar a ordenar una lista de costos, redactar una primera ficha de alcance o clasificar descripciones de tickets. Usa ejemplos ficticios o datos anonimizados y comprueba las sumas con una hoja de cálculo. Puede inventar condiciones, interpretar mal un contrato o proponer comandos incorrectos: una respuesta convincente no prueba que el servicio exista.
No pegues contraseñas, respaldos, datos personales ni información de clientes sin una base y autorización adecuadas. Mantén aprobación humana sobre precios, compromisos y cualquier cambio de infraestructura. La IA puede facilitar documentación; no sustituye una guardia técnica ni convierte un servicio sin supervisión en soporte permanente.
Preguntas frecuentes
¿Necesito comprar un servidor completo antes de conseguir clientes?
No siempre. Un piloto contratado por demanda o un servicio de administración sobre infraestructura del cliente puede limitar el gasto inicial. Revisa mínimos, permanencia, facturación y salida antes de decidir. No comprometas capacidad o licencias que todavía no puedes proporcionar.
¿Puedo incluir respaldo como un extra opcional?
Puedes definir paquetes distintos, pero la necesidad de recuperación no desaparece. Explica qué datos no se respaldan, quién asume esa tarea y qué ocurre ante una pérdida. Si el cliente no acepta un mínimo operativo necesario para su aplicación, es mejor no ofrecer ese alcance que ocultar la limitación.
¿Cómo compito sin ser el más barato?
Con una entrega verificable: alcance claro, respuesta acordada, recuperación probada y una salida ordenada. No todos los clientes necesitan ese nivel. Si solo buscan infraestructura y pueden administrarla, pagar tu intermediación puede no aportarles suficiente valor.
Pide una propuesta que puedas comparar
Prepara esta ficha: modelo de reventa, número inicial de clientes, aplicaciones, recursos estimados, datos que deben recuperarse, horarios, reparto del soporte, licencias, identidad visible y procedimiento de salida. Solicita costos recurrentes, alta y extras por separado. Pide que cualquier “incluido” tenga un alcance escrito.
Puedes revisar los VPS administrados de Cobalt como punto de partida técnico. Esa página no acredita por sí sola un convenio de reventa ni marca blanca. Para analizar el caso, envía tu ficha y solicita alcance y responsabilidades. Compara la respuesta con otras opciones o conserva la operación propia si cubre tus necesidades.